ArticlesOutils d'écriture
Mes textos en anglais sonnent-ils polis? Ce que peut vérifier une personne qui écrit en anglais langue seconde, et ce qu'elle ne peut pas
Pourquoi un message correct en anglais peut quand même paraître abrupt, pourquoi il n'y a pas un seul anglais poli, dix messages réécrits, et la part qu'aucun outil ne voit.
Par Samet Durgun · Cofondateur de Subtext · 47 min de lecture
· Mis à jour le 12 novembre 2026
En bref
Une grammaire correcte ne règle pas la question. Dans la plupart des études citées ici, surtout sur des courriels d'étudiants à leurs professeurs, les lecteurs de langue maternelle anglaise jugeaient la brusquerie sur le caractère direct et l'adoucissement plus que sur les erreurs: une demande sèche, sans salutation ni formule de fin, et sans signe que la personne savait qu'elle demandait quelque chose. Ces formules d'usage peuvent se vérifier et s'apprendre. Savoir si ce lecteur, dans cette relation, prendra vos mots comme vous l'entendiez ne peut qu'être estimé, par vous ou par un outil qui part de ce que vous lui dites.
Trois choses à vérifier
- La demande laisse-t-elle au lecteur une façon de dire non, comme le fait « Could you send it when you have a chance? »?
- Dans un premier message à quelqu'un de haut placé, gardez une salutation et une formule de fin.
- Repérez les échéances que vous ne vouliez pas fixer, comme « as soon as possible ». Si rien ne presse, dites-le.
La plupart de la recherche derrière tout ça porte sur des courriels d'étudiants universitaires à leurs professeurs. Les textos de tous les jours dans une langue seconde n'ont presque pas été étudiés.
Votre texto en anglais, trop direct?
Subtext marque où une demande se lit comme un ordre et offre des versions plus polies.
Votre grammaire peut être correcte et le message sonner quand même abrupt. Dans la plupart des études à l’origine de cet article, des lecteurs de langue maternelle anglaise jugeaient un courriel abrupt à cause de son caractère direct et du peu d’adoucissement, pas à cause de ses erreurs. Un correcteur de grammaire ne peut donc pas dire à une personne qui écrit en anglais langue seconde si son message sonne poli. Ce qui distinguait les courriels abrupts, c’était une demande formulée trop directement, sans mots pour l’adoucir, sans salutation ni formule de clôture, et sans aucun signe que la personne savait qu’elle demandait quelque chose. Ces habitudes viennent souvent de la langue première, et elles sont invisibles pour tout ce qui vérifie l’orthographe et l’accord des verbes. Dans la seule expérience qui faisait varier les fautes d’orthographe et de grammaire, la plupart des impressions négatives créées par ces fautes diminuaient quand les lecteurs savaient que l’expéditeur venait d’une autre culture (voir plus bas).
La plupart des outils vers lesquels les gens se tournent vérifient la grammaire, la fluidité et la formalité. Un groupe plus restreint lit le ton. Aucun ne sait à qui vous écrivez à moins que vous le disiez, ni l’ampleur du service demandé, ni ce qui est poli dans la culture de cette personne, et cette dernière couche est celle où la recherche situe l’essentiel des dégâts.
Il n’y a pas non plus de norme unique à viser. Les rédacteurs britanniques et américains emploient please à peu près aussi souvent les uns que les autres, pour des usages différents. L’anglais indien a ses propres formes, bien documentées. Un fil Slack entre un collègue allemand et un collègue brésilien suit probablement les habitudes de l’équipe plus que celles de l’un ou l’autre pays, même si je n’ai trouvé là-dessus aucune étude que je pouvais vérifier. La question utile, c’est donc de savoir si votre message sonne naturel et poli pour la personne qui le lit, compte tenu de ce que vous vouliez dire. Qu’il sonne comme celui d’un locuteur natif compte beaucoup moins.
J’ai cofondé Subtext, un vérificateur de ton, alors j’ai un intérêt dans la façon dont les quatre dernières sections se lisent. C’est là que je décris ce qu’il fait, et il apparaît quatre fois en passant avant elles, dont une fois pour ce que disent ses conditions. La recherche qui les précède vient de sources que j’ai ouvertes moi-même, dans certains cas seulement le résumé ou une page qui décrit l’étude, comme l’indique la liste des sources. Les dix réécritures et les listes de vérification sont de moi. Pour la mise à jour du 13 octobre 2026, j’ai intégré à l’article d’origine deux rapports de recherche produits par IA, j’ai retracé chacune de leurs affirmations jusqu’à sa source, et j’ai laissé tomber ce qui ne tenait pas la route. La première de ces quatre sections montre ce que Subtext a relevé dans la demande inventée « Send me the report until tomorrow. » et les versions qu’il a offertes.
Quatre choses différentes peuvent clocher dans un message
La grammaire, le naturel, le registre et la politesse sont quatre vérifications distinctes, et un message peut réussir l’une et échouer à la suivante.
- La grammaire, c’est de savoir si les formes sont correctes: le temps des verbes, les articles, l’ordre des mots, l’orthographe. « Sorry for late » y échoue.
- Le naturel, c’est de savoir si les gens qui emploient l’anglais dans ce contexte le diraient de cette façon. « I have another plan » est clair et sonne un peu faux, parce que l’anglais s’est fixé sur « I already have plans ». Ces combinaisons figées diffèrent d’une variété d’anglais à l’autre, et c’est pourquoi naturel veut toujours dire naturel pour quelqu’un.
- Le registre, c’est de savoir si le degré de formalité convient au canal et à la relation. « I would like to inform you that I will be late » convient à une lettre officielle et détonne dans un clavardage de groupe.
- La politesse, c’est de savoir si le message traite la relation comme vous l’entendiez: l’ampleur de ce que vous demandez, la part de choix que vous laissez, la chaleur que vous montrez. « Send me the file today » réussit les trois premières vérifications et peut quand même échouer à celle-ci.
Les correcteurs de grammaire sont bons pour la première. Les outils de réécriture aident pour la deuxième et la troisième. La quatrième dépend de qui lit, et c’est d’elle que parle la plus grande partie de la recherche ci-dessous.
Pourquoi un message anglais correct peut quand même passer pour impoli
Un message peut être parfait sur le plan grammatical et échouer quand même, parce que la politesse en anglais se loge surtout dans les mots autour de la demande. Economidou-Kogetsidis a étudié 200 demandes par courriel que des étudiants chypriotes grecs envoyaient à des professeurs dans une université de Chypre qui enseigne en anglais, à raison d’un courriel par étudiant, le tout envoyé à 11 enseignants sur 18 mois1. Dans 75 des 82 demandes d’information, soit environ 91 %, les étudiants formulaient leur demande directement. Seulement 16,5 % commençaient par une salutation comme « Hello » ou « Good morning ». La plupart des autres commençaient par une formule d’adresse seule, comme « Dear » suivi d’un nom, et 14,5 % par rien du tout. Seulement 23 % se terminaient par une formule de clôture comme « Best » ou « Sincerely », même si 70 % disaient bel et bien merci. Les courriels se distinguaient par une « significant directness », surtout dans les demandes d’information, par « an absence of lexical/phrasal downgraders », par des salutations et des formules de clôture omises, et par des formules d’adresse que l’auteure jugeait inappropriées ou inacceptables. Selon elle, ces courriels peuvent être lus comme impolis parce qu’ils « appear to give the faculty no choice in complying with the request and fail to acknowledge the imposition involved »1. Le titre de l’article est tiré des données, « Please answer me as soon as possible », et il montre le schéma en sept mots. La personne veut être courtoise, emploie le mot please, et produit quand même une phrase qui impose une échéance au lecteur.
Un atténuateur (downgrader) est un petit mot qui réduit la pression. « I was wondering whether », « if you have a moment », « would it be at all possible ». Beaucoup de rédacteurs britanniques et américains y recourent. Les personnes qui viennent de langues où la formulation directe est la politesse par défaut peuvent les omettre et ajouter un please à la place. Dans une étude de 2013 sur 4 353 demandes sur Wikipédia, évaluées chacune par cinq annotateurs américains, Danescu-Niculescu-Mizil et ses collègues ont trouvé qu’un please au milieu d’une phrase obtenait en moyenne +0,49 sur leur échelle de politesse, contre -0,30 pour une demande qui commençait par « Please »2. Ils lisent un please en ouverture comme une stratégie directe qui peut sembler insincère. L’étude ne rapporte pas la langue première des rédacteurs, alors elle montre comment des évaluateurs américains entendent un please en tête de phrase, et non qui en écrit un.
Les locuteurs natifs écrivent aussi de façon directe, mais ont plus de façons d’adoucir
Le style direct est courant chez les rédacteurs natifs aussi, et ce qui sépare les groupes, c’est la quantité d’adoucissement qu’ils ajoutent. Biesenbach-Lucas a comparé les demandes par courriel adressées à des professeurs par des étudiants des cycles supérieurs, locuteurs natifs et non natifs de l’anglais, dans une université américaine3. Elle a analysé 533 courriels que des étudiants des cycles supérieurs en TESOL ont envoyés à un seul professeur sur six sessions, 382 de locuteurs natifs et 151 de locuteurs non natifs, et tous les rédacteurs non natifs venaient d’un milieu asiatique. Les deux groupes écrivaient plus de demandes directes et d’allusions que de formes conventionnellement indirectes, telles qu’on les trouve dans les anciennes études sur les actes de langage, alors la dérive ne se limite pas aux apprenants. Mais les locuteurs natifs « demonstrate greater resources in creating e-polite messages to their professors than nonnative speakers »3. Ils avaient plus de façons d’adoucir, et ils s’en servaient davantage. Les groupes sont de taille inégale. L’étude énumère comme limites le professeur unique et l’échantillon restreint de locuteurs non natifs (tous issus de langues asiatiques, tous dans un même programme d’études), alors elle décrit un contexte et ne tranche pas la question.
Ce que les lecteurs natifs vous reprochent vraiment
L’étude de 2011 a aussi demandé à 24 enseignants universitaires britanniques, de 12 universités du Royaume-Uni, d’évaluer six des courriels d’étudiants1. Leur note de politesse la plus basse et leur note la plus haute pour le caractère abrupt (1,38 et 4,67, sur des échelles de cinq points) sont allées à un courriel qui plaçait un please devant un impératif et n’avait ni salutation, ni formule de clôture, ni remerciement. Deux autres courriels bâtis sur le même please suivi d’un impératif ont été jugés plus polis, et l’auteure attribue la différence au merci placé avant la formule de clôture.
Les lecteurs natifs jugent l’expéditeur autant que la phrase, et ils jugent le registre plus sévèrement que la grammaire. Dans une étude de perception ultérieure, Economidou-Kogetsidis a montré les mêmes courriels d’étudiants, directs et sans adoucissement, à des apprenants chypriotes grecs et à des enseignants universitaires de langue maternelle anglaise4. Les deux groupes avaient des « significantly mismatching perceptions of what is appropriate ». Dans la plupart des cas, les enseignants natifs ont évalué le même courriel comme « significantly more abrupt, less polite and as not adequately acknowledging the imposition involved », et ils ont évalué la personnalité de l’expéditeur « significantly less favorably » que les apprenants4.
Hendriks a mené deux expériences en ligne où des anglophones natifs lisaient des demandes par courriel écrites par des apprenants néerlandais, en faisant varier les mots d’adoucissement. Les 110 évaluateurs de la première expérience et les 158 de la seconde ont évalué la compréhensibilité et la personnalité de l’expéditeur5. Sous-utiliser ces mots d’adoucissement « had a negative effect on participants’ evaluation of the personality of the sender of the e-mail »5. Le message était compris dans les deux cas. L’effet portait sur l’amabilité apparente de l’expéditeur, il venait d’une seule expression, et il était faible, environ un tiers de point sur une échelle de cinq points.
Une étude de 2023 dont Hendriks est aussi la première signataire a trouvé une pénalité encore plus étroite. Elle a présenté à 120 lecteurs néerlandais et 131 lecteurs britanniques l’une de quatre versions d’un courriel de demande venant d’un collègue6. La version sèche (« Can you send me… ») faisait paraître l’expéditeur plus autoritaire. Mais le courriel sec d’un rédacteur néerlandais était aussi jugé comme ayant plus d’autorité et suscitait plus de volonté de s’exécuter, alors que celui d’un rédacteur anglais était jugé moins compétent. Les auteurs disent que l’omission des mots d’adoucissement « may have a limited but important impact ». Dans cette étude, les lecteurs exigeaient du rédacteur natif qu’il respecte la convention d’adoucissement et laissaient plus de marge au rédacteur néerlandais, ce qu’il vaut la peine de se rappeler avant de tenir pour acquis que chaque lecteur note votre anglais.
Les lecteurs pardonnent plus facilement la grammaire que le ton
Les lecteurs pardonnent plus facilement les fautes de grammaire qu’un ton sec, et Vignovic et Thompson ont testé si le fait de savoir que l’expéditeur vient d’une autre culture donne droit à de l’indulgence7. Des lecteurs ont jugé la conscienciosité, l’intelligence, l’amabilité et la fiabilité d’un expéditeur de courriel, entre autres traits, après avoir lu des messages contenant des fautes d’orthographe et de grammaire, ou des messages qui enfreignaient les normes d’étiquette, que les auteurs définissaient comme des messages courts sans ton de conversation. Les fautes de grammaire produisaient des impressions négatives, et la plupart de ces impressions diminuaient quand les lecteurs apprenaient que l’expéditeur venait d’une autre culture. Les entorses à l’étiquette, c’était différent. Les attributions négatives « were not significantly mitigated by knowledge that the e-mail sender was from a foreign culture »7. Un lecteur va largement excuser votre grammaire quand il sait que l’anglais est votre langue seconde. Il n’excusera pas un ton sec de la même façon. L’article y voit une question d’attribution, les fautes de grammaire étant mises sur le compte de la situation et un ton sec sur celui de la personne.
Quel anglais sert de norme?
La plupart des études ci-dessus installent des lecteurs britanniques ou américains dans le fauteuil du lecteur. Cela en fait de bonnes preuves au sujet de ces lecteurs et des preuves faibles au sujet de l’anglais en général, parce que les variétés diffèrent justement aux endroits où un message est jugé.
Prenez please. Des études antérieures sur les demandes le trouvaient environ deux fois plus souvent dans les énoncés directifs britanniques que dans les américains8. Murphy a examiné l’anglais du web des deux pays, environ 386 millions de mots pour chacun, et a trouvé le mot lui-même presque aussi courant des deux côtés, avec 1,5 % de plus dans la moitié britannique8. Ce qui différait, c’était le travail qu’il faisait. Le please britannique était plus souvent une routine, le please des consignes et des avis. Le please américain apparaissait plus souvent là où l’enjeu était plus grand entre la personne qui écrit et celle qui lit, et la variante dédaigneuse, comme dans « oh, please », était plus de deux fois plus fréquente dans l’échantillon américain, même si les nombres sont petits, 20 contre 9 sur 800 emplois de chaque côté. Le même mot peut se lire comme une habitude pour un lecteur et comme un choix appuyé pour un autre.
L’anglais indien et l’anglais sri-lankais ont été mesurés aussi. Degenhardt a comparé des demandes tirées d’enregistrements oraux de Grande-Bretagne, d’Inde et du Sri Lanka et a trouvé l’anglais indien à peu près aussi direct que l’anglais britannique dans l’ensemble, soit 45,8 % des demandes formulées directement contre 44,8 %, l’anglais sri-lankais étant plus direct, à 56,5 %9. Les différences étaient une question de degré, et elles dépendaient plus du type de phrase que du pays. La comparaison que Xie a faite des formules de politesse dans l’anglais du web britannique, australien et hongkongais a trouvé que l’anglais de Hong Kong était le plus hésitant, surtout à cause de please, et que l’anglais australien devançait le britannique tant pour les formes de déférence que pour celles de solidarité amicale10. Sorry apparaissait environ 87 fois par million de mots dans l’échantillon britannique, 77 dans l’australien et 40 dans celui de Hong Kong.
Certaines formes appartiennent surtout à une variété. Le dictionnaire d’Oxford pour apprenants indique que « do the needful », qui veut dire faire ce qui est nécessaire, relève surtout de l’anglais indien11. Dans cet anglais-là, c’est une expression de tous les jours. Un client en Ohio ne saura peut-être pas à quoi renvoie the needful, et c’est une raison de nommer l’action pour ce lecteur. L’expression elle-même est correcte.
Une grande partie de l’anglais de tous les jours s’écrit aussi dans des groupes où ce n’est la langue première de personne: le canal Slack d’une entreprise en démarrage de Berlin, le fil avec un fournisseur entre Istanbul et Séoul. Là, les attentes du lecteur viennent de l’équipe. Je n’ai pas trouvé d’étude sur la politesse dans ce genre de clavardage de tous les jours que je pouvais vérifier comme il faut, alors je m’en tiens à une règle pratique: demandez-vous à quoi votre vrai lecteur est habitué avant de vous demander ce qu’un locuteur natif écrirait.
Les problèmes de formule et les problèmes de situation
Thomas a tracé la ligne qui explique pourquoi une partie de tout cela peut se vérifier et une autre, non12. Elle a appelé échec pragmatique l’incapacité de comprendre « what is meant by what is said », et l’a divisé en deux. L’échec pragmalinguistique relève d’un « highly conventionalized usage which can be taught quite straightforwardly as ‘part of the grammar’ ». L’échec sociopragmatique est « much more difficult to deal with, since it involves the student’s system of beliefs as much as his/her knowledge of the language »12.
Dans la pratique, le premier type, c’est le « I was wondering if » qui manque ou le « please answer me as soon as possible ». C’est un problème de formule, et un outil ou un guide de conversation peut le repérer. Le second type, c’est de décider qu’une demande d’une seule ligne à un collègue plus haut placé n’a aucun besoin d’être adoucie, parce que dans votre langue première ce serait le cas. Aucune formule ne règle ça, parce que les mots sont bons et que c’est la situation qui a été mal lue.
Les apprenants remarquent aussi ces deux types d’erreur différemment selon l’endroit où ils vivent. Bardovi-Harlig et Dörnyei ont demandé à des apprenants d’anglais de juger des énoncés qui étaient soit fautifs sur le plan grammatical, soit inappropriés selon le contexte13. Les apprenants qui étudiaient l’anglais dans un pays où on le parle ont jugé les erreurs pragmatiques plus graves que les erreurs grammaticales. Ceux qui l’étudiaient dans leur pays d’origine ont jugé les erreurs grammaticales plus graves13. Une personne qui a étudié l’anglais dans son pays d’origine tend donc à juger les erreurs de grammaire plus graves que les autres, alors que les études ci-dessus ont constaté que les lecteurs natifs réagissaient davantage au caractère direct de la demande et à l’adoucissement.
Trois questions qui déterminent combien d’adoucissement il faut à un message
Politeness: Some Universals in Language Usage de Brown et Levinson, le modèle de la politesse le plus connu, donne une prise concrète sur le second type de problème14. Les demandes, les refus et les plaintes mettent en péril la « face », l’image publique de soi que chacun veut qu’on laisse intacte. La face positive, c’est le désir d’être aimé et approuvé. La face négative, c’est le désir de ne rien se faire imposer. À quel point un message menace l’une ou l’autre dépend de trois questions: connaissez-vous bien le lecteur, quel pouvoir a-t-il sur vous, et quelle est l’ampleur de ce que vous demandez? Plus le total est élevé, plus la personne qui écrit va chercher d’adoucissement, de chaleur ou de détours.
Les trois questions voyagent mieux que la théorie qui les sous-tend. La théorie de la face de Brown et Levinson fait débat depuis des décennies, surtout chez des chercheurs qui écrivent sur d’autres langues que l’anglais. Matsumoto a soutenu qu’en japonais, la préoccupation principale est la position qu’on occupe par rapport aux autres, alors les formes honorifiques marquent la relation même quand rien n’est imposé15. Ide a défendu une idée voisine, soit qu’une grande partie de la politesse japonaise relève du discernement, c’est-à-dire choisir la forme que la situation commande, plus que d’une stratégie choisie pour sauver la face16. Mao a soutenu que les notions chinoises de face, mianzi et lian, ne correspondent pas à la face positive et à la face négative17. Fukada et Asato ont répondu que le modèle peut bel et bien expliquer les formes honorifiques du japonais, parce qu’une personne de statut plus élevé fait monter le pouvoir et la distance18. Le débat reste ouvert. Pour un message, la lecture prudente est que la distance, le pouvoir et l’ampleur de la demande comptent presque partout, et que les mots qui montrent que vous en avez tenu compte changent d’une langue à l’autre.
Ce que l’enseignement et une meilleure maîtrise changent
L’enseignement comme une meilleure maîtrise de la langue aident pour les formules usuelles, et ni l’un ni l’autre ne comble tout l’écart. Usó-Juan a recueilli 110 demandes par courriel authentiques que des apprenants espagnols d’anglais langue étrangère ont envoyées à trois membres du corps professoral, avant et après une période d’enseignement de stratégies, et a trouvé les demandes plus appropriées par la suite19. Le résumé rapporte une comparaison avant et après, sans groupe témoin ni test différé mentionnés, alors il montre que les formules peuvent s’enseigner, et non que le gain dure. Qin, Jia et Ren ont analysé 306 courriels de demande de 32 enseignants anglophones et de 121 apprenants dont la langue première était le chinois, le français ou l’espagnol20. La langue première des apprenants avait un effet significatif sur leur écriture. Les apprenants de niveau plus élevé employaient plus de stratégies de demande indirectes, mais n’avaient pas développé la compétence pragmatique nécessaire pour ajuster leur usage d’un contexte écrit à l’autre. Un apprenant plus avancé emploie plus de demandes indirectes et ne s’adapte pas encore à la situation, ce qui ressemble à la seconde catégorie de Thomas12.
Le portrait d’ensemble est encourageant, avec un bémol. Une méta-analyse de 29 études sur l’enseignement, portant sur 1 898 apprenants, a trouvé un grand effet moyen de l’enseignement de la pragmatique (g = 1,66), et les gains les plus importants apparaissaient dans les tâches écrites de complétion de discours, ces tests où l’on décrit un scénario et sur lesquels le domaine s’appuie21. Les gains à un test de ce genre en disent moins sur les messages adressés à de vraies personnes. Nguyen a suivi 32 étudiants vietnamiens spécialisés en anglais, dont 13 avaient reçu six heures d’enseignement explicite sur les demandes par courriel, et a constaté que leur avantage était toujours là huit mois plus tard dans des courriels sollicités22. Les salutations, les demandes indirectes et le fait de laisser un choix au lecteur se sont améliorés et le sont restés. Les formules de clôture se sont améliorées au début et avaient reperdu la plus grande partie du terrain gagné au bout de huit mois, et le fait de donner des raisons, les formules de désamorçage et les compliments n’ont pas changé du tout.
La plupart de ces recherches portent sur des courriels à des professeurs
Les données sur les demandes sont bonnes parce que les chercheurs ont pu recueillir de vrais courriels, et presque tous ces courriels ont été envoyés par des étudiants universitaires à leurs enseignants, une relation où l’écart de pouvoir est grand et les conventions, fixes. Les refus et les excuses ont surtout été étudiés au moyen de tâches de complétion de discours, où les gens écrivent ce qu’ils diraient dans une situation décrite. L’étude classique sur les refus d’apprenants japonais de l’anglais fonctionnait ainsi, avec 60 participants en trois groupes de 20 qui répondaient à des scénarios écrits23. Golato a comparé les réponses à une tâche écrite avec des enregistrements du même genre de moment dans de vraies conversations et a trouvé que les deux captaient des choses différentes: les enregistrements montraient comment les gens répondent sur le coup, et les réponses écrites reflétaient leur expérience accumulée de la langue24. Les textos de tous les jours écrits dans une langue seconde, à des amis, à des propriétaires ou à des collègues, ont à peine été étudiés.
Le domaine met aussi en garde contre le raccourci auquel ce genre de recherche invite. House et Kádár le disent sans détour: « By degrading learners to cultural robots, the researcher precludes unearthing fine-tuned pragmatic conventions »25. Votre langue première peut influencer les formules anglaises qui vous semblent naturelles. Des gens qui partagent une langue première écrivent quand même de façons très différentes, et rien dans ces études ne prédit comment une personne en particulier écrit.
Pourquoi vous ne pouvez pas l’entendre vous-même
Relire son propre message ne suffit peut-être pas à repérer cela, pour deux raisons. La première est générale, et elle est traitée dans est-ce que ce texto a l’air bête. Kruger et ses collègues ont mené cinq expériences sur le ton dans les courriels, et leurs résultats laissent penser que les gens ont tendance à croire qu’ils communiquent par courriel plus efficacement qu’ils ne le font. Leurs quatrième et cinquième expériences suggèrent que la cause est que les rédacteurs « entendent » un énoncé comme ils l’ont voulu, ce qui leur rend difficile de voir que le public peut ne pas l’entendre ainsi26. Une étude de 2025 sur des textos du quotidien (347 destinataires, 171 expéditeurs) et des courriels de travail ou d’études (361 destinataires, 61 expéditeurs) n’a trouvé aucun signe de ton positif ou négatif mal interprété27. Elle évaluait le ton positif ou négatif, pas la politesse, alors elle laisse ouverte la question de cette section. La seconde raison est une inférence tirée des études ci-dessus, pas un constat, et elle est propre à l’écriture dans une langue seconde. La voix silencieuse que vous entendez lit selon les règles de politesse de votre langue première. Une demande tout à fait courtoise en grec ou en néerlandais vous semble courtoise en anglais aussi, parce que le jugement est porté par la même oreille.
C’est pourquoi l’écart de perception dans la seconde étude d’Economidou-Kogetsidis est si large4. Les apprenants ont jugé leur propre type de courriel approprié parce que, selon les normes avec lesquelles ils ont grandi, il l’était. Les enseignants l’ont jugé abrupt parce que, selon les leurs, il l’était. Chaque groupe lisait le courriel avec justesse selon ses propres normes.
Se demander si son anglais sonne poli, c’est donc se demander comment il sonne pour un lecteur dont on ne peut pas vérifier les attentes, et c’est à ça que sert un second lecteur, que ce soit un ami à l’aise en anglais ou un outil comme Subtext. Le côté lecteur du même écart, comprendre ce que voulait dire un message qu’on a reçu, est traité dans qu’est-ce que ce texto veut dire.
L’anxiété d’écrire dans une langue seconde, mesurée
L’anxiété d’écrire dans une langue seconde se mesure depuis vingt ans. Cheng a bâti une échelle pour la mesurer à partir des témoignages de 65 apprenants et l’a validée auprès de 421 étudiants spécialisés en anglais langue étrangère dans sept établissements d’enseignement supérieur de Taïwan, en divisant l’anxiété en symptômes physiques, en pensées inquiètes et en évitement pur et simple de l’écriture28. Une méta-analyse de 2022 a regroupé 84 tailles d’effet tirées de 22 études et a trouvé que l’anxiété d’écriture était modérément liée à une écriture plus faible (une corrélation d’environ 0,3) et à une confiance moindre en sa propre écriture (environ 0,4)29. Ce sont deux corrélations, surtout tirées d’étudiants qui écrivaient pour leurs cours. Elles ne montrent pas que l’anxiété fait moins bien écrire, et elles ne disent rien de direct sur un texto de deux lignes à un propriétaire. La version de tous les jours se trouve dans pourquoi les textos vous donnent de l’anxiété.
Dix messages, avant et après
Chaque paire ci-dessous commence par un message qui est grammatical, ou presque, et qui risque de paraître plus brusque ou plus raide que ce que voulait la personne qui l’a écrit. La seconde version est une option parmi d’autres. Une version pour votre lecteur peut être plus chaleureuse, plus courte ou plus formelle, et dans certaines relations la première version convient.
1. Demander quelque chose à un collègue, sur Slack
Avant: « Please send me the final numbers today. I need them for the meeting. »
Après: « Could you send me the final numbers today? I need them for the 4pm meeting. Thanks. »
Pour les évaluateurs américains de l’étude sur Wikipédia, une demande qui commençait par please se lisait comme moins polie que le point neutre2. La forme interrogative laisse de la place pour un non. Votre raison faisait déjà du bon travail, alors elle reste.
2. Relancer un propriétaire
Avant: « Why did you not answer my email? The heating is still not working. Please fix it as soon as possible. »
Après: « Hi Alex, I’m following up on my email from Tuesday about the heating. It still isn’t working. Could you let me know when someone can come and look at it this week? Thanks. »
« Why did you not » se lit comme une accusation, et « as soon as possible » est l’expression dont l’article de 2011 a tiré son titre1. La réécriture maintient la pression au moyen d’une date et d’une prochaine étape concrète. Si la réparation est une obligation légale du propriétaire, vous pouvez être plus ferme, et une formulation polie ne veut jamais dire renoncer à ce que vous réclamez.
3. Répondre à un gestionnaire
Avant: « OK. I will do it. »
Après: « Sure, happy to take it. I’ll go through the notes before Thursday. »
Deux phrases courtes, avec des points et sans contractions, peuvent donner une impression de réticence dans un clavardage. Les entorses à l’étiquette que les lecteurs n’excusaient pas dans l’étude de Vignovic et Thompson étaient de ce genre, des messages courts sans ton de conversation7. La question de savoir si le point empire les choses est traitée dans est-ce qu’un point fait paraître un texto fâché.
4. Refuser l’invitation de quelqu’un que vous venez de rencontrer
Avant: « No, I cannot come. I have another plan. »
Après: « Thanks so much for the invite. I’m sorry, I already have plans on Saturday. I hope it’s a great party. »
« I already have plans » est l’expression consacrée. Un merci, un court regret et un bon souhait forment le coussin habituel autour d’un non en anglais. Les refus ont surtout été étudiés au moyen de tâches à réponses sollicitées, alors voyez ce coussin comme une habitude bonne à connaître, pas comme un effet mesuré.
5. Demander un service à un ami
Avant: « Can you bring me to the station tomorrow? »
Après: « Any chance you could give me a lift to the station tomorrow? »
« Bring me to the station » se comprend, et c’est courant en anglais irlandais, même si beaucoup de lecteurs britanniques et américains diraient take. « Give me a lift » est la tournure britannique et « give me a ride » l’américaine, et aucune des deux variétés n’est la bonne. « Any chance » rend le service facile à refuser.
6. S’excuser auprès d’un client pour une réponse tardive
Avant: « Sorry for my late answer. I was very busy. »
Après: « Sorry for the slow reply. Here are the answers to your questions. »
Une raison aide quand elle apprend quelque chose au lecteur. « I was very busy » dit seulement au client qu’il passait en deuxième, alors on l’enlève, et le lecteur veut surtout les réponses. Une seule phrase d’excuse claire suffit habituellement au travail. Pour en savoir plus, voyez comment s’excuser par texto.
7. Relancer le service à la clientèle pour un remboursement
Avant: « I am still waiting for my money. When will you send it? »
Après: « Hello, I’m writing about the refund for order 4812, which I returned on 2 October. Could you tell me when it will be processed? Thank you. »
Avec le service à la clientèle, la politesse consiste surtout à faciliter le travail de l’agent: le numéro de commande, la date et une seule question claire. Ici, les précisions font plus que la chaleur.
8. Dire non à du travail supplémentaire
Avant: « I don’t have time for this. »
Après: « I’d like to help, but the launch has taken my whole week. Could I look at it on Monday? »
Le non devient un « pas cette semaine ». Une raison et une solution de rechange montrent que vous avez pris la demande au sérieux. La recherche sur les situations où refuser vous coûte quelque chose se trouve dans comment dire non à du travail supplémentaire.
9. Demander à un client international de corriger une facture
Avant: « Kindly do the needful. »
Après: « Could you please correct the VAT number on the invoice and send it back? »
« Do the needful » est bien établi en anglais indien, et le dictionnaire d’Oxford pour apprenants l’étiquette comme relevant surtout de l’anglais indien11. Un lecteur hors de cette variété ne saura peut-être pas ce qu’est the needful, alors la réécriture nomme l’action. Si votre lecteur écrit lui aussi en anglais indien, l’original fonctionne.
10. Dire dans un clavardage de groupe que vous êtes en retard
Avant: « Dear all, I would like to inform you that I will be late to the meeting. »
Après: « Running 10 minutes late, start without me. »
L’original est correct et naturel dans une lettre officielle. Dans un clavardage où tout le monde écrit par fragments, il paraît raide, et s’ajuster au canal règle le problème.
Des vérifications qui ne demandent pas d’application
Quatre vérifications attrapent une bonne part de tout cela, et chacune a son angle mort.
- Une banque de formules, comme le guide d’une université sur les courriels, vous donne des formules usuelles éprouvées. Elle ne peut pas vous dire si une formule convient à ce lecteur, et beaucoup sont écrites pour une seule variété et un seul registre formel.
- Un ami à l’aise en anglais connaît peut-être le lecteur et le contexte. Son idée de la politesse reste la sienne, et vous n’avez peut-être pas envie de lui montrer le message.
- Lire le message à voix haute fait ressortir les mots manquants et un rythme haché. Le lire sur le ton que vous redoutez est la version qui a quelques données derrière elle, et il en est question plus bas.
- Se calquer sur l’autre personne, soit la longueur de ses messages, sa salutation, sa ponctuation et ses emojis, est l’indice local le plus rapide que vous ayez. Ça ne fonctionne qu’une fois qu’elle a écrit, et renvoyer à un gestionnaire son propre style laconique peut quand même mal passer.
Ce que les outils de grammaire et de fluidité vérifient, selon leurs propres mots
Les grands outils d’écriture promettent surtout la correction et la fluidité, et certains promettent la formalité. Chacune des quatre descriptions ci-dessous cite la page de l’outil lui-même, alors aucune n’est une fonction que j’ai déduite.
La page d’accueil de LanguageTool décrit un correcteur pour les « grammatical errors and spelling mistakes across languages », dit qu’il « masters more than 30 languages and dialects », et offre un outil de paraphrase qui reformule « to be more formal, fluent, simple or concise »30. Son menu de produits dit que le correcteur « helps you find the right tone », mais rien sur la page ne dit qu’il détecte la politesse.
Selon son propre blogue, DeepL Write prend en charge l’anglais, l’allemand, le français, l’espagnol, l’italien, le portugais, le chinois (simplifié), le japonais et le coréen, et, pour le français et l’espagnol du moins dans ce billet, permet de choisir un style (Business, Academic, Simple, Casual) et un ton (Friendly, Diplomatic, Confident, Enthusiastic)31. Ce sont deux réglages que vous appliquez, et l’outil ne détecte pas si votre brouillon était diplomate.
Wordtune promet de « Switch between casual and formal tones with the click of a button », dit qu’il « can only write in English », et affirme que sa fonction de traduction « will make you sound like a native-English speaker with just a click »32. Les deux premières affirmations se vérifient. La troisième est du marketing.
Selon son propre blogue, le paraphraseur de QuillBot offre deux modes gratuits (Standard et Fluency) et neuf modes prédéfinis pour les abonnés payants, fonctionne « in over 25 languages » et s’adresse aux gens qui écrivent « in a first, second, or third language »33. Là encore, les modes sont des consignes que vous lui donnez.
Deux autres types d’outils servent à cela sans avoir été conçus pour ça, et ici je n’ai aucune page à citer, seulement ma propre observation. Un traducteur a tendance à garder le registre dans lequel vous avez écrit, alors une demande directe dans votre langue première arrive habituellement en anglais sous forme de demande directe. Les robots conversationnels généraux comme ChatGPT peuvent faire une bonne critique d’un message si vous leur dites qui est le lecteur et ce que vous voulez, et ils ne travaillent qu’à partir de ce que vous leur dites. Plusieurs des grands s’entraînent sur ce que vous collez à moins que vous désactiviez cette option, comme l’a constaté un examen des politiques de treize assistants d’écriture.
Tous ces outils peuvent rendre une phrase plus fluide et plus formelle. Formel et poli sont deux qualités différentes, et la recherche ci-dessus porte justement sur cette différence. Une phrase formelle qui ne laisse quand même aucun choix au lecteur reste le genre de courriel dont l’article de 2011 a tiré son titre.
Ce que les outils de ton vérifient
Deux outils affirment lire le ton avant l’envoi et un troisième réécrit dans cette direction, et ce qu’ils affirment est plus étroit que la question que vous posez. Un quatrième, QuillBot, évalue le ton après une paraphrase.
La page de ton de Grammarly présente un ensemble d’étiquettes pour le ton général d’un texte, comme Formal, Confident, Accusatory et Worried, sans rien dire des langues autres que l’anglais, de ses limites ni de qui est le lecteur34. Ce que le détecteur lit est traité dans la détection du ton par l’IA. La comparaison avec un lecteur conçu pour les messages se trouve dans Subtext contre Grammarly.
Sur sa fiche de l’App Store, Tonely est « the world’s first On device Ethical AI-powered iMessage extension and keyboard designed to help you understand how your words may come across before you press send », fonctionne entièrement sur l’appareil, indique l’anglais comme seule langue, et se télécharge gratuitement avec un abonnement de 9,99 $ par mois ou de 99,99 $ par année35. Le traitement sur l’appareil est un avantage pour la vie privée, et l’anglais seulement est une limite pour quiconque écrit aussi dans sa langue première.
La page d’accueil de ConfiText dit qu’il « rewrites your messages so they come across clear, confident, and exactly how you meant them »36. Elle ne nomme aucune langue et n’affirme pas lire comment un message sera reçu avant de le réécrire.
La page d’aide de QuillBot, mise à jour le 10 juin 2026, décrit des réglages de ton Premium qui « help you see how the tone of your text changes after paraphrasing »37. Un panneau trace l’original et la paraphrase sur cinq échelles (Casual to Formal, Unfriendly to Friendly, Wordy to Concise, Complex to Simple et Unclear to Clear). Ces échelles évaluent le texte lui-même, et la page ne dit rien de la politesse ni de la façon dont un lecteur le jugera.
Ce que chaque type d’outil vérifie
| Type d’outil | Ce qu’il vérifie | Ce qu’il ne peut pas savoir |
|---|---|---|
| Correcteur de grammaire | L’orthographe, la grammaire, la ponctuation, un peu de style | Si le message convient à ce lecteur |
| Outil de paraphrase ou de réécriture | La fluidité et la formalité, dans les modes que vous choisissez | Comment se lit votre brouillon d’origine |
| Traducteur | Le sens d’une langue à l’autre | Si la politesse a suivi |
| Robot conversationnel général | Ce que vous lui demandez, avec le contexte que vous donnez | Tout ce que vous omettez |
| Vérificateur de ton | Comment le brouillon risque de se lire | Votre relation avec le lecteur, à moins que vous la lui décriviez |
| Ami à l’aise en anglais | Le naturel, le registre, parfois le lecteur | Si son idée de la politesse correspond à celle du lecteur |
Un programme peut-il évaluer la politesse?
Un programme peut évaluer la politesse de demandes en anglais presque aussi bien qu’une personne à l’intérieur d’un même site, et il reste à la traîne d’un site à l’autre et d’une langue à l’autre. Danescu-Niculescu-Mizil et ses collègues ont bâti un classificateur de politesse à partir d’un corpus de demandes annotées, avec des caractéristiques qui représentent l’indirection, la déférence et l’impersonnalisation, et ont rapporté qu’il « achieves close to human performance and is effective across domains »2. La base est plus étroite que la citation. L’article de 2013 a fait évaluer chacune de 10 957 demandes en anglais (4 353 de Wikipédia, 6 604 de Stack Exchange) par cinq annotateurs américains, et n’a testé que le quart le plus poli et le quart le moins poli de chaque ensemble. À l’intérieur d’un même site, le classificateur a obtenu 83,79 % sur Wikipédia et 78,19 % sur Stack Exchange, contre une exactitude humaine de 86,72 % et de 80,89 %.
Entraîné sur Wikipédia et testé sur Stack Exchange, il a obtenu 67,53 % contre 80,89 % pour les humains, et dans l’autre sens 75,43 % contre 86,72 %. Quand Srinivasan et Choi ont bâti TyDiP, un jeu de données de politesse comprenant 500 exemples annotés dans chacune de neuf langues typologiquement diverses, les modèles multilingues ont transféré assez bien leur entraînement en anglais aux autres langues, de l’avis des auteurs, « yet fall short of estimated human accuracy significantly »38. Le même article se demandait aussi si chaque stratégie de politesse de l’anglais conserve son effet une fois transposée dans d’autres langues, et si la formalité et la politesse concordent. Ni l’un ni l’autre ne se vérifie chaque fois.
Un outil de ton peut-il juger l’anglais d’une personne qui l’écrit en langue seconde?
Une lecture du ton de votre anglais est une estimation, parce qu’aucune des deux études de classificateurs citées plus haut ne précise si ses demandes venaient de rédacteurs qui écrivaient dans une langue seconde. Les outils ci-dessus qui lisent le ton font un travail de ce genre, quel que soit leur fonctionnement interne. Les données publiées disent que les modèles testés jusqu’ici sont bons en anglais et accusent un retard mesurable sur les humains dans d’autres langues, et que les stratégies qui rendent une phrase anglaise polie ne se transposent pas une à une. Même là où un modèle est le plus fort, il modélise un lecteur générique.
Le test le plus proche est une donnée voisine, pas un test de ton. Liang et ses collègues ont fait passer sept détecteurs de textes d’IA sur 91 dissertations du TOEFL écrites par des humains et sur 88 dissertations d’élèves américains de huitième année en 202339. Les détecteurs étaient presque parfaits sur les dissertations des élèves de huitième année et ont classé à tort plus de la moitié des dissertations du TOEFL comme écrites par une IA, soit un taux moyen de faux positifs de 61,3 %. Cela ne dit rien des outils de ton. Relire le message comme le ferait son destinataire, chaque fois qu’une note de ton sur votre propre anglais vous inquiète, est une précaution raisonnable de toute façon.
Ce que la rétroaction de l’IA fait à l’anglais d’une personne qui l’écrit en langue seconde
La recherche sur l’IA générative qui donne de la rétroaction aux personnes écrivant dans une langue seconde a grandi vite, et elle pointe dans deux directions. Une revue exploratoire de 51 études a constaté que 17 d’entre elles rapportaient des gains dans la qualité de l’écriture, que la détection des erreurs était plus fiable en anglais qu’en grec ou en chinois, et que seulement la moitié environ des études rapportaient les consignes qu’elles avaient utilisées40. La rétroaction de l’IA et celle d’un enseignant, ensemble, ont fait mieux que l’une ou l’autre seule.
Les corrections sont réelles, et superficielles d’une façon bien précise. Chon et Shin ont demandé à 40 étudiants coréens en enseignement de l’anglais d’écrire, de laisser ChatGPT corriger leur texte, puis de le réviser avec son aide41. La correction directe a réglé 86 % des erreurs d’origine, et les révisions faites par les étudiants eux-mêmes avec l’appui de l’IA, 77 %. Les erreurs qui restaient touchaient surtout le choix des mots et la structure des phrases, celles qui demandaient un jugement sur le contexte, et les auteurs décrivent les gains comme étant à court terme. Dans une étude de cas de quatre apprenants chinois, les deux qui recevaient 11 ou 12 corrections par tâche révisaient correctement environ les trois quarts du temps, et les deux qui en recevaient plus de 22 y arrivaient dans environ 60 % des cas42. Il est tentant de blâmer le simple nombre de corrections, mais les deux qui en recevaient plus étaient aussi ceux qui écrivaient le moins bien, ce qui est l’explication que les auteurs donnent de l’écart, et quatre apprenants ne permettent pas de départager les deux.
La voix fait aussi partie des coûts. Dans une expérience menée auprès de 118 rédacteurs en Inde et aux États-Unis, Agarwal, Naaman et Vashistha ont constaté que la saisie semi-automatique par IA donnait aux Américains de plus grands gains d’efficacité et tirait les rédacteurs indiens vers des styles américains43. Une prépublication de 2026 de Liu et Zhu a fait réviser 106 dissertations d’étudiants universitaires chinois par quatre modèles d’IA44. Chaque modèle a corrigé la grammaire et gardé le sens, et chaque modèle a retranché à peu près les trois quarts, ou plus, des pronoms qui s’adressent au lecteur, comme « we », « you » et « our ». Les questions rhétoriques ont diminué aussi, d’un quart à plus des quatre cinquièmes selon le modèle. Les modèles avaient reçu la consigne de respecter les normes de l’écriture universitaire américaine et britannique d’élite, ce que les auteurs comptent parmi les limites, alors une partie de cet aplanissement, c’est ce qui était demandé. La prépublication n’est pas évaluée par les pairs, n’utilise aucun test statistique et ne faisait intervenir aucun rédacteur se servant de l’IA, alors elle montre ce que les modèles font à un texte fini. Ce qui arrive aux rédacteurs qui s’en servent est une autre question. Les données plus larges sur les réécritures et la voix se trouvent dans l’IA rend-elle vos textos robotiques.
Aucune de ces études n’a testé si le fait d’utiliser un outil de ton ou de réécriture rend quelqu’un meilleur pour écrire des messages sans cet outil. Cette question reste ouverte.
Ce qu’aucun outil ne peut vérifier
Aucun outil ne connaît la chose que la recherche juge la plus importante, soit qui lit, au-delà de ce que vous lui dites. Chaque étude de perception ci-dessus a obtenu son résultat en gardant le message constant et en changeant le lecteur. Le même courriel était acceptable pour un apprenant et abrupt pour un enseignant4. La même faute de grammaire était jugée moins sévèrement quand le lecteur connaissait l’origine de l’expéditeur, et pas autrement7. Un outil voit le message. Il ne voit pas l’enseignant, ni le poids du service qu’on demande.
Savoir si votre relation avec ce lecteur permet une demande sans fioritures, si un message de deux lignes à cette personne se lit comme efficace ou comme froid, et si le dérangement est assez petit pour se passer d’excuses, ce sont toutes des croyances sur la situation, ce qui nous ramène à la seconde catégorie de Thomas12. Un outil peut vous dire que la phrase est directe. Il ne peut pas vous dire si être direct était le bon choix, et le domaine n’a pas cette certitude à offrir. Les outils de réécriture partagent cette limite, parce que la plupart rendent un nouveau texte sans dire comment le lecteur le prendra, ce que le bilan des réécriveurs de messages par IA a constaté dans les principaux types d’applications.
Ce qu’un outil peut faire, c’est lire le brouillon comme quelqu’un d’autre que vous. Il peut remarquer qu’une demande n’a aucun adoucissement, qu’un message n’a pas de salutation, qu’une ligne fixe une échéance que vous ne comptiez pas fixer. Cela couvre la première catégorie, les formules usuelles, qui selon Thomas est « fairly easy to overcome »12. Pour qui écrit dans une langue seconde, cela couvre l’essentiel des corrections faciles, et c’est la partie pour laquelle votre propre oreille est la moins fiable.
Comment vérifier soi-même son anglais avant de l’envoyer?
Commencez par la forme de la demande. Laisse-t-elle au lecteur une façon de dire non? La conclusion de 2011 était que les courriels peuvent être lus comme impolis quand ils « give the faculty no choice »1. « Could you send it when you have a chance » en laisse une. « Send it by Friday » n’en laisse pas, et un « Please » en ouverture n’est pas un correctif fiable non plus. Les demandes qui commençaient par « Please » obtenaient en moyenne -0,30 sur l’échelle de politesse des évaluateurs américains de l’étude sur Wikipédia2.
Utilisez un atténuateur qui change la lecture de la demande. Dans les expériences de Hendriks, remplacer « can » par « could » n’a rien changé, et « I was wondering if » était le seul modificateur associé à un expéditeur jugé plus aimable, par une faible marge. Ajouter « possibly » n’a fait aucune différence5.
Reconnaissez que vous demandez un service. Une seule proposition qui montre que vous savez que vous demandez quelque chose, « I know you’re busy », apporte ce qui manquait selon les enseignants de l’étude de perception4.
Gardez la salutation et la formule de clôture dans un premier message. Leur absence était l’une des caractéristiques que l’étude de 2011 a relevées dans les courriels qui passaient pour impolis1. Personne ne les attend dans un clavardage en cours, mais dans un premier courriel à une personne plus haut placée, on s’attend à les trouver.
Surveillez vos échéances. « As soon as possible » est l’expression qui a donné son titre à l’article1. Si rien ne presse, dites-le.
Relisez ensuite comme si vous étiez agacé. La raison se trouve dans l’article sur pourquoi on ne peut pas savoir si son propre texto sonne impoli. Dans la quatrième expérience de Kruger et de ses collègues, 54 étudiants ont lu leurs énoncés à voix haute, la moitié sur le ton voulu et l’autre moitié sur le ton opposé, et seule cette seconde moitié a cessé de surestimer la facilité avec laquelle un partenaire les décoderait26. C’était une seule expérience, sur le sarcasme, alors prenez cela comme une précaution.
Une liste de vérification pour la minute avant l’envoi:
- Qui lit, connaissez-vous bien cette personne, et quel pouvoir a-t-elle sur vous?
- Quelle est l’ampleur de la demande? Une plus grosse demande a besoin de plus de coussin.
- Le lecteur a-t-il une façon de dire non?
- Y a-t-il une salutation et une formule de clôture qui conviennent au canal?
- Avez-vous donné une raison pour l’échéance, le refus ou le retard?
- Une ligne sonne-t-elle comme une accusation quand vous la lisez en étant agacé?
- Si l’autre personne a écrit en premier, votre message correspond-il à la longueur et au degré de formalité du sien?
- Y a-t-il un signe de chaleur, si c’est de la chaleur que vous ressentez?
- Vous excusez-vous ou vous expliquez-vous plus que la situation le demande?
- Si un outil l’a réécrit, est-ce que ça sonne encore comme vous et est-ce que ça dit encore ce que vous vouliez dire?
Coller un fil, c’est coller les mots de quelqu’un d’autre
N’importe quel vérificateur fonctionne mieux avec du contexte, et le contexte, c’est habituellement les messages de l’autre personne. Une capture d’écran porte son nom, ses mots et parfois son numéro, et cette personne n’a jamais accepté que ça aille où que ce soit. Rognez l’image pour en retirer les noms et les numéros dont vous n’avez pas besoin, collez seulement votre brouillon quand le brouillon suffit, et gardez les messages de travail hors de tout outil que votre employeur n’a pas approuvé. Les conditions de Subtext vous confient cette responsabilité. Elles notent que les captures d’écran et les messages contiennent souvent les mots de quelqu’un d’autre, et qu’en les soumettant vous confirmez avoir légalement le droit de le faire45.
À quel point tout cela est établi
| Affirmation | Les données à l’appui | Solidité |
|---|---|---|
| La grammaire et la politesse sont deux problèmes distincts | Une théorie fondatrice et des décennies de recherche sur les apprenants | Forte |
| Les courriels directs et sans adoucissement adressés à des enseignants passent pour impolis auprès d’enseignants britanniques et d’autres évaluateurs de langue maternelle anglaise | De vrais courriels et des études d’évaluation, surtout avec des rédacteurs chypriotes grecs et néerlandais | Modérée, pour ce contexte |
| Les lecteurs excusent plus facilement les fautes de grammaire qu’un ton sec | Une seule expérience | Limitée |
| Les lecteurs jugent toujours plus sévèrement les rédacteurs non natifs | Une expérience a trouvé l’inverse pour les courriels secs | Non appuyée |
| Il existe une seule norme britannique ou américaine de l’anglais poli | Des études de corpus sur plusieurs variétés d’anglais | Contredite |
| Les formules usuelles peuvent s’enseigner | Une méta-analyse, une étude sur huit mois et une étude avant-après, surtout sur des tâches de test | Modérée à forte |
| Les constats sur les refus et les excuses prédisent les textos de tous les jours | Surtout des tâches à réponses sollicitées | Faible |
| La rétroaction de l’IA corrige les erreurs de surface | Une revue exploratoire et deux petites études | Modérée |
| Les suggestions de l’IA tirent l’écriture vers les normes américaines | Une expérience et une prépublication | Limitée |
| Les applications de ton, Subtext compris, font mieux écrire les gens | Aucune étude trouvée | Aucune |
Ce que Subtext vérifie dans un brouillon sur le point d’être envoyé
Subtext, l’application que j’ai cofondée, nomme des problèmes comme une formulation qui met de la pression ou qui exige trop, ce qui recoupe une partie de la première catégorie de la division de Thomas, les faux pas conventionnels. Ses consignes ne comptent pas l’absence de mots d’adoucissement ou de salutations parmi ses vérifications, même si, sur le brouillon ci-dessous, il a reproché à un ordre de n’avoir rien pour l’adoucir. Il fonctionne en 20+ langues et répond dans la langue où vous écrivez46. J’ai lu les consignes internes de l’application pour savoir ce qu’elle renvoie, le marquage à l’écran est tel que l’application l’affiche, et ce qu’elle fait de vos données est tel que sa politique de confidentialité l’énonce. Ce que l’application renvoie pour chaque brouillon est décrit en détail dans ce que fait l’application Subtext.
Pour un message que vous êtes sur le point d’envoyer, Subtext nomme jusqu’à trois problèmes dans votre brouillon, du plus grave au moins grave, marque les mots en cause, lit l’émotion principale, et propose jusqu’à trois versions, chacune portant un score « prêt à envoyer », affiché sous forme de badge, qui dit la probabilité qu’elle soit reçue comme vous l’entendiez. Chaque problème a une courte explication qui cite vos propres mots quand elle pointe une expression, et la pression, les exigences excessives, la condescendance et un ton robotique en font partie. Chaque version corrige ce qui a été signalé tout en gardant votre sens et votre registre, et porte une phrase à elle qui nomme ce qui la fait bien passer ou ce qui pourrait être mal interprété, que son score soit élevé ou bas. Subtext est payant après les premières analyses.
Après la lecture, les ajustements en un toucher comprennent Plus poli, Plus simple, Plus chaleureux, Plus court, Plus assuré et Plus décontracté. Le bouton Plus décontracté envoie la consigne « Sound more natural », et c’est ce que l’application a de plus proche de la vérification du naturel décrite au début de cet article46. Le score va de 5 à 100. La FAQ de Subtext dit elle-même que le score ne lit que les mots qu’il a devant lui, qu’il ne peut pas connaître la personne à qui vous écrivez, et qu’il faut le prendre « as a second reading rather than a measurement »46. Cette phrase date d’avant la Mémoire. Quand une personne est enregistrée, la note derrière le badge « prêt à envoyer » peut s’appuyer sur ce que vous avez enregistré à son sujet, et elle n’en sait toujours pas plus que ce que contiennent ces notes.
Une demande inventée, du genre de celles qu’on obtient en traduisant mot à mot, montre dans l’ordre la lecture, les versions et un ajustement en un toucher. L’application était réglée en français, mais comme le brouillon était en anglais, elle a répondu en anglais. Les boutons et les badges, eux, sont restés en français. Sur le brouillon « Send me the report until tomorrow. », Subtext a surligné toute la phrase et a renvoyé les étiquettes Overly demanding et Clarity. La première note disait que la phrase « is an order with a deadline and no softening, so it may feel curt », un ordre avec une échéance et rien pour l’adoucir. La seconde disait que « Until tomorrow » est ambigu, parce que ça pourrait vouloir dire avant le début ou d’ici la fin de la journée de demain. Sa version la plus proche se lisait « Could you send me the report by tomorrow, please? » Un toucher sur Plus poli a produit « Would it be possible for you to send me the report by tomorrow, please? Thank you very much. », une version marquée « prêt à envoyer ». C’est le vrai résultat de l’application, sans retouche. Les versions disent « by tomorrow », et l’application a seulement précisé « I read “until tomorrow” as “by tomorrow” ». Rien n’a dit à la personne que « until » était une erreur d’anglais, et pas juste une ambiguïté. Des trois premières versions, seule la troisième, « Natural rewrite », réglait la question que sa propre note Clarity soulevait, avec « by the end of tomorrow », et elle ajoutait une raison que la personne n’avait pas donnée, ce que l’application a signalé elle-même.
Send me the report until tomorrow.
Quick deadlines are normal, let's just make it sound friendly and clear. Here are a few options.
- Close to yours (Courteous, prêt à envoyer): Could you send me the report by tomorrow, please? It keeps your request and deadline but swaps the order for a polite question with "by tomorrow", which is clearer. Should land well.
- Warmer polish (Friendly, prêt à envoyer): Hi, could you send me the report by tomorrow? Thanks a lot, I appreciate it. The friendly greeting and thanks soften the deadline while "by tomorrow" stays clear. Should be received well.
- Natural rewrite (Collaborative, prêt à envoyer): Hey, I need the report for something coming up. Would you be able to get it to me by the end of tomorrow? If that's a squeeze, just let me know and we can sort it out. Thank you! It gives a clear deadline and room to push back, which feels collaborative. It adds a reason ("something coming up") you didn't mention, so check it fits.
I read "until tomorrow" as "by tomorrow", and the last draft adds a reason you didn't give, so cut it if it's not true. Want it shorter, warmer, or more confident?
Plus poli
Happy to make it a bit more diplomatic while keeping the deadline clear.
- More diplomatic (Respectful, prêt à envoyer): Would it be possible for you to send me the report by tomorrow, please? Thank you very much. "Would it be possible" and the closing thanks make the request gentle, and "by tomorrow" keeps the deadline clear. Should land well.
Want it a touch warmer or shorter?
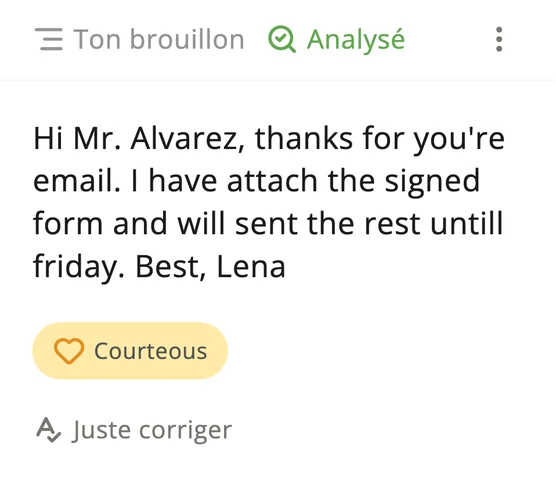
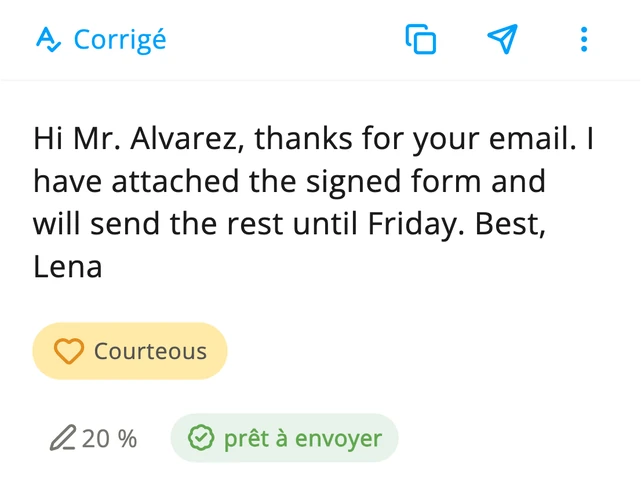
Subtext a aussi un mode plus restreint, Juste corriger, qu’on choisit en bas à gauche de la zone de saisie, qui vérifie l’orthographe et la grammaire et ne touche pas à la formulation. Un exemple du 21 octobre 2026, avec un brouillon inventé et la vraie réponse de l’application, montre où passe cette limite. Le brouillon était « Hi Mr. Alvarez, thanks for you’re email. I have attach the signed form and will sent the rest untill friday. Best, Lena ». Subtext n’y a mis aucune étiquette, y a lu l’émotion Courteous et a écrit « Your message is polite and clear, it just had a few small slips. Here’s the corrected version. » La version, dans une carte intitulée Corrigé, se lit « Hi Mr. Alvarez, thanks for your email. I have attached the signed form and will send the rest until Friday. Best, Lena ». Cinq fautes ont disparu. La sixième est celle de l’exemple ci-dessus, et elle est restée: Subtext a laissé « until Friday » en place et a seulement ajouté, comme une option, que ça pourrait aussi s’écrire « by Friday », « which is the more usual phrasing for a deadline ». Avec Juste corriger, lisez donc sa note autant que sa version.
Est-ce que Subtext demande à qui vous écrivez?
Subtext peut s’informer du lecteur. Ses consignes lui demandent de lire le message « the way a native speaker of its language would hear it ». Pour les langues où la politesse est grammaticale, dont le japonais, le coréen, le turc et l’allemand, il pose des questions sur la relation, ou écrit au niveau le plus poli quand il doit rédiger sans réponse. L’anglais ne marque pas la politesse dans sa grammaire, alors cette règle ne s’applique pas aux brouillons en anglais. Dans toutes les langues, quand un brouillon tient tête à quelqu’un (un refus, une limite, une confrontation) et que rien ne dit à qui il s’adresse, Subtext demande qui est le destinataire avant de rédiger, alors que les messages de tous les jours reçoivent un brouillon tout de suite. Comment ce lecteur, dans cette relation, va prendre vos mots, ça reste à vous de le juger, ce qui est la seconde catégorie de Thomas. Aucune étude citée ici n’a testé Subtext, ni aucun outil ci-dessus, sur de l’anglais écrit en langue seconde, alors, à part les deux brouillons ci-dessus, dont aucun n’est un test d’anglais écrit en langue seconde, ce que je décris est ce que ses consignes disent qu’il fait.
Vous pouvez aussi dire à Subtext qui est votre lecteur et lui demander de le retenir. Depuis octobre 2026, la Mémoire contient des notes sur les personnes que vous enregistrez.
Ce que Subtext fait d’un message reçu
Pour un message que vous avez reçu, Subtext donne un résumé en une ligne de ce que l’autre personne attend de vous et de deux à cinq points d’action, plus une réponse si vous en demandez une, sans étiquette sur le ton de l’expéditeur, alors la lecture du ton ne porte que sur votre propre brouillon.
Il ne connaît votre lecteur que dans la mesure où vous le lui dites. Dites-lui une fois que votre gestionnaire aime les messages courts et demandez-lui de s’en souvenir, et la Mémoire le garde sous forme de note sur votre façon d’écrire à cette personne, que vous pouvez lire, modifier ou supprimer, et qui reste jusqu’à ce que vous la supprimiez. Il ne connaît pas les conventions de votre domaine. Il peut signaler une demande qui presse ou qui exige, un des faux pas conventionnels, comme dans des messages de travail fermes sans être froids. Servez-vous-en comme d’un second lecteur, et relisez quand même le message comme le ferait le destinataire.
Subtext envoie le texte que vous soumettez aux fournisseurs que sa politique de confidentialité nomme, alors ce texte quitte votre appareil. Rien de ce que vous soumettez ne sert à entraîner un modèle d’IA, et la politique dit qu’aucun de ces fournisseurs n’a non plus le droit de s’en servir pour l’entraîner45. Une conversation est supprimée des serveurs de Subtext cinq jours après votre dernière utilisation, ou 90 jours si vous l’épinglez. Côté fournisseurs, la politique dit qu’Anthropic supprime les entrées et les sorties dans un délai de 30 jours et peut conserver jusqu’à 2 ans une requête signalée et jusqu’à 7 ans les scores de sécurité associés, que Deepgram (transcription vocale), avec l’option de retrait que Subtext a activée, ne garde l’audio que le temps de la transcription, qu’OpenAI conserve les requêtes de lecture à voix haute jusqu’à 30 jours, et que Subtext n’a aucune entente de rétention zéro avec aucun d’eux45. Un examen des politiques de treize assistants d’écriture, qui détaille aussi la rétention des fournisseurs, a constaté que plusieurs outils ci-dessus s’entraînent par défaut sur le texte collé, dont Grammarly et QuillBot sur les comptes individuels et le forfait gratuit de DeepL Write.
Ce que Subtext peut et ne peut pas faire pour une personne qui écrit en anglais langue seconde
Subtext peut:
- lire un brouillon et marquer les mots qui risquent d’être reçus comme de la pression, des exigences, de la condescendance ou un ton robotique
- proposer jusqu’à trois versions et des ajustements en un toucher comme Plus chaleureux, Plus court et Plus décontracté
- répondre dans la langue où vous écrivez, en 20+ langues
- demander à qui s’adresse un message quand le brouillon tient tête à quelqu’un
Subtext ne peut pas:
- garantir qu’un message convient à un lecteur ou à une variété d’anglais en particulier
- connaître votre relation au-delà de ce que vous lui dites
- démontrer que son utilisation améliore votre propre écriture avec le temps
- citer une étude indépendante sur l’exactitude de ses lectures
Prenez ce que dit Subtext comme une deuxième lecture de votre brouillon. Essayer Subtext dans votre navigateurDisponible dans l'App StoreDisponible sur Google PlayScannez-le avec l'appareil photo de votre téléphone pour installer.
Sources
Numérotées dans l’ordre d’apparition ci-dessus. Chaque DOI a été résolu auprès de Crossref. Les sources de la première version ont été ouvertes les 4 et 5 octobre 2026, et les études de Kruger et de Pollmann ont été ajoutées et vérifiées le 10 octobre 2026. Les sources ajoutées dans la mise à jour ont été vérifiées les 12 et 13 octobre 2026, date à laquelle les pages de Subtext ont aussi été rouvertes. Aucune rétractation, aucune correction ni aucune expression d’inquiétude n’a été trouvée pour aucune des études citées, d’après les notices des éditeurs, Crossref et OpenAlex.
- Economidou-Kogetsidis, M. (2011). “Please answer me as soon as possible”: Pragmatic failure in non-native speakers’ e-mail requests to faculty. Journal of Pragmatics, 43(13), 3193 à 3215. 200 courriels de 200 étudiants chypriotes grecs envoyés à 11 membres du corps professoral sur 18 mois, plus l’évaluation de six courriels par 24 enseignants universitaires britanniques de 12 universités du Royaume-Uni. Chiffres vérifiés dans le texte intégral (copie d’auteur) le 12 octobre 2026; aucun financement déclaré.
- Danescu-Niculescu-Mizil, C., Sudhof, M., Jurafsky, D., Leskovec, J., Potts, C. (2013). A computational approach to politeness with application to social factors. Proceedings of the 51st Annual Meeting of the Association for Computational Linguistics. Corpus de 10 957 demandes évaluées chacune par cinq annotateurs américains. Financé par la NSF, l’ARO, la DARPA et d’autres subventions et appuis d’entreprises.
- Biesenbach-Lucas, S. (2007). Students writing emails to faculty: An examination of e-politeness among native and non-native speakers of English. Language Learning & Technology, 11(2), 59 à 81. 533 courriels (382 de locuteurs natifs, 151 de non natifs) envoyés à un seul professeur sur six sessions; aucun financement déclaré.
- Economidou-Kogetsidis, M. (2016). Variation in evaluations of the (im)politeness of emails from L2 learners and perceptions of the personality of their senders. Journal of Pragmatics, 106, 1 à 19. Le nombre de participants n’était pas visible dans les parties que j’ai pu ouvrir.
- Hendriks, B. (2010). An experimental study of native speaker perceptions of non-native request modification in e-mails in English. Intercultural Pragmatics, 7(2), 221 à 255. Deux expériences en ligne avec 110 et 158 évaluateurs de langue maternelle anglaise; aucun financement déclaré.
- Hendriks, B., van Meurs, F., Kakisina, B. (2023). The effects of L1 and L2 writers’ varying politeness modification in English emails on L1 and L2 readers. Journal of Pragmatics, 204, 33 à 49. 120 participants néerlandais et 131 participants britanniques; aucun financement déclaré.
- Vignovic, J. A., Thompson, L. F. (2010). Computer-mediated cross-cultural collaboration: Attributing communication errors to the person versus the situation. Journal of Applied Psychology, 95(2), 265 à 276. La taille de l’échantillon n’est pas indiquée dans le résumé, la seule partie que j’ai pu ouvrir.
- Murphy, M. L. (2025). Separated by a common im/politeness marker: please in American and British web-based English. English Language and Linguistics, 29(4), 781 à 804. Corpus web GloWbE (recueilli en 2012), environ 386 millions de mots par variété, 800 emplois codés de please par variété, plus un sondage auprès de 1 325 adultes américains et de 1 293 adultes britanniques. Libre accès; assistance de recherche financée par l’Université du Sussex. Texte intégral lu le 12 octobre 2026.
- Degenhardt, J. (2023, en ligne en 2021). Requests in Indian and Sri Lankan English. World Englishes, 42(3), 523 à 543. Demandes tirées des sections de dialogue d’ICE-GB, d’ICE-India et d’ICE-Sri Lanka (enregistrements oraux). Financé par la Fondation allemande pour la recherche (DFG). Libre accès; texte intégral lu le 12 octobre 2026.
- Xie, F. (2024). Politeness Variation: Politeness in Britain, Australia, and Hong Kong. Corpus Pragmatics, 8(4), 313 à 333. Corpus web GloWbE, 21 formules de politesse, fréquences par million de mots. Libre accès financé par l’Université de Zurich; aucun conflit d’intérêts déclaré. Texte intégral lu le 12 octobre 2026.
- Oxford Learner’s Dictionaries. needful (noun), idiom “do the needful”. Vérifié le 12 octobre 2026.
- Thomas, J. (1983). Cross-cultural pragmatic failure. Applied Linguistics, 4(2), 91 à 112.
- Bardovi-Harlig, K., Dörnyei, Z. (1998). Do language learners recognize pragmatic violations? Pragmatic versus grammatical awareness in instructed L2 learning. TESOL Quarterly, 32(2), 233 à 262. Le constat est cité tel qu’il est énoncé sur la page de sa réplication, Niezgoda et Röver (2001), dans Pragmatics in Language Teaching, Cambridge University Press.
- Brown, P., Levinson, S. C. (1987). Politeness: Some Universals in Language Usage. Cambridge University Press. Réédition de leur essai de 1978 avec une nouvelle introduction. Détails bibliographiques et table des matières vérifiés le 12 octobre 2026; le texte du livre lui-même n’a pas été ouvert, et les définitions de la face sont telles que Matsumoto (1988) les cite d’après l’édition de 1978.
- Matsumoto, Y. (1988). Reexamination of the universality of face: Politeness phenomena in Japanese. Journal of Pragmatics, 12(4), 403 à 426. Texte intégral lu le 12 octobre 2026.
- Ide, S. (1989). Formal forms and discernment: two neglected aspects of universals of linguistic politeness. Multilingua, 8(2 à 3), 223 à 248. Pas en libre accès; l’argument est tel que le citent, numéros de page à l’appui, des auteurs ultérieurs (Mao 1994, Pizziconi 2003).
- Mao, L. R. (1994). Beyond politeness theory: ‘Face’ revisited and renewed. Journal of Pragmatics, 21(5), 451 à 486. Texte intégral lu en partie le 12 octobre 2026.
- Fukada, A., Asato, N. (2004). Universal politeness theory: application to the use of Japanese honorifics. Journal of Pragmatics, 36(11), 1991 à 2002. Texte intégral non ouvert; leur position est confirmée par la notice et par des citations ultérieures.
- Usó-Juan, E. (2022). Exploring the role of strategy instruction on learners’ ability to write authentic email requests to faculty. Language Teaching Research, 26(2), 213 à 237. 110 courriels avant et après l’enseignement; financé par le Ministerio de Ciencia e Innovacion de l’Espagne, l’Universitat Jaume I et la Generalitat Valenciana selon Crossref; seul le résumé m’était accessible.
- Qin, W., Jia, R., Ren, W. (2024). Pragmatic competence in an email writing task: Influences of situation, L1 background, and L2 proficiency. Written Communication, 41(4), 726 à 755. 306 courriels de 32 enseignants anglophones et de 121 apprenants; financé par le Shanghai Institute of Educational Science (C2023155) selon Crossref; seul le résumé m’était accessible.
- Ren, W., Li, S., Lü, X. (2023). A meta-analysis of the effectiveness of second language pragmatics instruction. Applied Linguistics, 44(6), 1010 à 1029. 29 études, 1 898 apprenants, 54 tailles d’effet; g global = 1,656. Résumé seulement; il ne dit pas si la différence entre les mesures de résultats était statistiquement significative.
- Nguyen, T. T. M. (2018). Pragmatic development in the instructed context: A longitudinal investigation of L2 email requests. Pragmatics, 28(2), 217 à 252. 32 étudiants vietnamiens d’anglais langue étrangère (13 ayant reçu l’enseignement, 19 dans le groupe de comparaison), courriels sollicités au moyen de trois scénarios, testés jusqu’à huit mois après l’enseignement. Texte intégral lu (copie d’auteur).
- Beebe, L. M., Takahashi, T., Uliss-Weltz, R. (1990). Pragmatic transfer in ESL refusals. Dans R. C. Scarcella, E. S. Andersen, S. D. Krashen (dir.), Developing Communicative Competence in a Second Language (p. 55 à 73). Newbury House. Plan et échantillon tels que les décrit la bibliographie du CARLA sur les actes de langage; le chapitre lui-même n’a pas été lu. Cette page présente une erreur de certificat dans certains navigateurs, et une copie archivée est disponible.
- Golato, A. (2003). Studying compliment responses: A comparison of DCTs and recordings of naturally occurring talk. Applied Linguistics, 24(1), 90 à 121. Résumé seulement.
- House, J., Kádár, D. Z. (2023, imprimé en 2025). Speech acts and interaction in second language pragmatics: A position paper. Language Teaching, 58(3), 396 à 407. Citation tirée de la p. 403. Libre accès; financé par l’Office national de la recherche, du développement et de l’innovation de la Hongrie; aucun conflit d’intérêts déclaré.
- Kruger, J., Epley, N., Parker, J., Ng, Z.-W. (2005). Egocentrism over e-mail: Can we communicate as well as we think? Journal of Personality and Social Psychology, 89(6), 925 à 936. Cinq expériences; la quatrième, sur la lecture d’énoncés à voix haute, comptait 54 étudiants de l’Université de l’Illinois; financé par une subvention du Board of Trustees de l’Université de l’Illinois et la subvention NSF SES-0241544. DOI résolu auprès de Crossref le 10 octobre 2026; résumé et quatrième expérience lus dans une copie intégrale de l’article, parce que la page de l’éditeur ne s’est pas chargée.
- Pollmann, M. M. H., Roos, C. A. (2025). “I get u”. People correctly interpret the tone of text messages and emails. Computers in Human Behavior Reports, 18, 100689. Étude 1, textos, 347 destinataires et 171 expéditeurs. Étude 2, courriels de travail ou d’études, 361 destinataires et 61 expéditeurs. Évalue seulement le ton positif ou négatif. Crossref n’indique aucun bailleur de fonds. DOI résolu auprès de Crossref le 10 octobre 2026; résumé lu sur OpenAlex, parce que la page de l’éditeur ne s’est pas ouverte.
- Cheng, Y.-S. (2004). A measure of second language writing anxiety: Scale development and preliminary validation. Journal of Second Language Writing, 13(4), 313 à 335. 421 étudiants spécialisés en anglais langue étrangère dans sept établissements d’enseignement supérieur de Taïwan. Résumé seulement.
- Li, R. (2022). Understanding foreign language writing anxiety and its correlates. Frontiers in Psychology, 13, 1031514. Méta-analyse de 22 études, 84 tailles d’effet; son total de 24 290 participants compte un échantillon une fois pour chaque taille d’effet; r combiné = -0,298 avec la performance en écriture et -0,382 avec le sentiment d’efficacité personnelle en écriture. Financé par la Social Science Foundation of Hunan Province. Libre accès; texte intégral lu le 12 octobre 2026.
- LanguageTool. Free AI Grammar Checker. Vérifié le 4 octobre 2026.
- DeepL. DeepL Write: your AI-powered writing assistant speaks French and Spanish. Vérifié le 4 octobre 2026.
- Wordtune. Express yourself with confidence. Vérifié le 4 octobre 2026.
- QuillBot. QuillBot’s Paraphraser: The Best AI Paraphrasing Tool. Vérifié le 4 octobre 2026.
- Grammarly. Writing Tone Detector and Tone Suggestions. Vérifié le 4 octobre 2026.
- Tonely AI Ltd. Tonely AI, App Store listing. Vérifié le 4 octobre 2026.
- ConfiText. AI Texting Assistant. Vérifié le 4 octobre 2026.
- QuillBot. How can I check and use Tone settings in Quillbot? Dernière mise à jour le 10 juin 2026; vérifié le 5 octobre 2026.
- Srinivasan, A., Choi, E. (2022). TyDiP: A dataset for politeness classification in nine typologically diverse languages. Findings of the Association for Computational Linguistics: EMNLP 2022.
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. 91 dissertations du TOEFL et 88 dissertations d’élèves américains de huitième année; financé par la NSF, les NIH, la Silicon Valley Foundation et la Chan Zuckerberg Initiative. Aucune rétractation ni correction trouvée le 12 octobre 2026.
- Crosthwaite, P., Sun, S. (2025, numéro de 2026). Generative AI and L2 Written Feedback Studies: A Scoping Review. RELC Journal, 57(1), 207 à 219. 51 études, recherche menée jusqu’en avril 2025. Libre accès; aucun financement ni conflit d’intérêts déclaré. Texte intégral lu le 12 octobre 2026.
- Chon, Y. V., Shin, D. (2026). AI Chatbot as a Revision Aid in Second Language Writing: From Error Correction to Lexical Sophistication. Journal of Computer Assisted Learning, 42(3), e70259. 40 étudiants universitaires coréens en enseignement de l’anglais, dont 39 analysés, une seule séance. Financé par l’Université Hanyang. Résumé lu le 12 octobre 2026.
- Yan, D., Zhang, S. (2024). L2 writer engagement with automated written corrective feedback provided by ChatGPT: A mixed-method multiple case study. Humanities and Social Sciences Communications, 11, 1086. Quatre apprenants d’une université chinoise, cinq semaines; descriptif seulement. Texte intégral lu le 12 octobre 2026.
- Agarwal, D., Naaman, M., Vashistha, A. (2025). AI Suggestions Homogenize Writing Toward Western Styles and Diminish Cultural Nuances. Proceedings of the 2025 CHI Conference on Human Factors in Computing Systems. 118 participants en Inde et aux États-Unis. Financé par Infosys, le Microsoft AFMR Program et Global Cornell, avec un appui partiel de la NSF.
- Liu, A., Zhu, S. (2026). The Cost of Perfect English: Pragmatic Flattening and the Erasure of Authorial Voice in L2 Writing Supported by GenAI. Prépublication arXiv 2605.13055, non évaluée par les pairs. 106 dissertations du corpus d’apprenants ICNALE, 424 révisions par IA faites par quatre modèles; statistiques descriptives seulement; aucune déclaration de financement.
- Subtext, Terms, privacy and your account. Conditions mises à jour le 26 juillet 2026, politique de confidentialité mise à jour le 10 octobre 2026. Vérifié le 12 octobre 2026.
- Subtext, page d’accueil et FAQ. Vérifié le 12 octobre 2026.