ArticoliStrumenti di scrittura
L'AI può leggere uno screenshot dei tuoi messaggi. Non sempre lo legge bene.
I tassi di errore pubblicati nella lettura di testo piccolo e non latino dentro uno screenshot, il divario del dark mode che nessuno ha misurato, cosa dicono tre app per screenshot sul tuo caricamento, e se rimuovere i metadati serve davvero a qualcosa di misurabile.
Di Samet Durgun · Cofondatore di Subtext · 15 min di lettura
· Aggiornato il 12 novembre 2026
In breve
Con un testo inglese chiaro, gli strumenti AI di solito leggono bene uno screenshot di una chat. L'accuratezza pubblicata cala quando i caratteri sono piccoli, l'immagine ha una bassa risoluzione o la scrittura non è latina, e in un test del 2023 su GPT-4V crollava per il cinese e l'arabo. Nessuno dei test che ho trovato usava veri screenshot di chat, e non ho trovato nessun test pubblicato sulla dark mode.
Uno screenshot di chat da leggere?
Subtext riassume cosa vogliono da te e ciò che carichi non addestra alcun modello.
Incolla uno screenshot di una chat in uno strumento di AI e di solito funziona senza problemi. Ti dice chi ha detto cosa, coglie la battuta, e scrive una bozza di risposta che ha senso. “Di solito” è la parte a cui nessuno mette un numero, e la tengo separata da una domanda diversa che questo sito tratta già altrove. Una volta che un modello ha le parole davanti a sé, capire chi sta parlando tra un turno e l’altro, tenere traccia di una domanda a cui nessuno ha risposto, leggere il sarcasmo, è l’argomento della pagina su come leggere il messaggio che hai ricevuto e della ricerca dietro leggere un intero thread prima di rispondere. Questo pezzo riguarda il passaggio precedente, se il modello legge correttamente l’immagine, prima di tutto il resto.
Contribuisco a costruire Subtext, un’app che controlla il tono e scrive bozze di risposta, e che prende uno screenshot di una chat come uno dei suoi input, quindi ho un motivo per volere qui una risposta favorevole. Non ce l’ho. Quello che segue è quello che sono riuscito a verificare su una domanda più ristretta e meno lusinghiera, quanto sono bravi i modelli con capacità di visione di oggi a leggere uno screenshot di telefono come immagine, non come trascrizione, e cosa succede a uno screenshot una volta che lo consegni a una di queste app. Ogni fonte qui sotto è una che ho aperto io stesso.
Verso la fine, due esempi di Subtext su screenshot di chat disegnati mostrano come va la lettura nel caso facile, e solo in quello.
Leggere uno screenshot è un problema di immagine prima che di linguaggio
Uno screenshot di una chat è un’immagine fatta di luce, non un blocco di testo che un computer può già analizzare. Prima che un modello possa ragionare su cosa dice un messaggio, deve trasformare correttamente i pixel in caratteri, qualunque sia il font, la dimensione, il contrasto e il layout che l’app di messaggistica ha usato. Questo passaggio è il riconoscimento ottico dei caratteri, l’OCR, che si appoggia allo stesso sistema visivo che legge qualsiasi altra immagine. La maggior parte delle affermazioni sull’accuratezza dell’AI nella messaggistica riguarda il ragionamento che avviene dopo questo passaggio. Poche riguardano il passaggio in sé.
I numeri che esistono
Il test più diretto è una valutazione del 2023 sulla capacità OCR di GPT-4V su diversi benchmark1. Sul testo di scena in inglese ha ottenuto l’88.0% di accuratezza a livello di parola sul benchmark CUTE80 e tra il 62.0% e il 66.0% su tre set inglesi più difficili, contro un intervallo dal 68.2% al 98.6% ottenuto da un sistema OCR specializzato sugli stessi quattro benchmark. Sul testo di scena in cinese, il benchmark ReCTS, GPT-4V ha ottenuto zero. In un test multilingue separato nello stesso paper, il suo punteggio F1 di text-spotting ha raggiunto l’82.49% per l’inglese e l’83.42% per il francese, contro il 16.55% per l’arabo e l’1.36% per il cinese. Il paper afferma chiaramente che “nonostante la sua versatilità nel gestire diversi compiti di OCR, GPT-4V non supera i modelli OCR specializzati allo stato dell’arte”, e che ha “mostrato limiti nel trattare lingue non latine”1.
Questa è una sola generazione di modelli, testata su dataset curati di testo di scena, non su screenshot di messaggistica, quindi va letta come un limite inferiore del problema generale, non come un verdetto su qualsiasi app disponibile oggi. Resta comunque il numero più diretto e verificabile contro l’affermazione semplice secondo cui l’AI legge le scritture non latine dentro un’immagine tanto bene quanto legge quelle latine. In base a queste prove, non è così.
Anche la risoluzione conta. Lo stesso paper ha trovato “una correlazione positiva tra la risoluzione dell’immagine in ingresso e la prestazione nel riconoscimento”1, il che gioca contro uno screenshot compresso o fortemente ridotto di scala, esattamente quello che molti telefoni producono quando le persone risalvano o ricondividono un’immagine, ancora prima che il modello legga una sola parola. Un preprint del 2025, più circoscritto, ha testato questo aspetto in modo più preciso, anche se solo su singoli caratteri kanji giapponesi resi a dimensioni controllate, non su screenshot di chat. I modelli multimodali hanno eguagliato un metodo OCR dedicato a circa 300 pixel per pollice, e “la loro prestazione peggiora in modo significativo sotto i 150 ppi”2. Non ho trovato un test che verifichi se quella soglia valga anche per il testo piccolo dentro uno screenshot di telefono compresso. La direzione, cioè un testo più piccolo e a risoluzione più bassa che peggiora più in fretta per questi modelli rispetto a un OCR costruito apposta, è il punto su cui i due paper separati concordano.
Sul dark mode in particolare, e sul testo a basso contrasto più in generale, non sono riuscito a trovare una valutazione pubblicata che misuri l’accuratezza dei modelli multimodali contro gli equivalenti in modalità chiara degli stessi screenshot. Le pipeline OCR classiche invertono di norma le immagini scure prima di elaborarle, perché l’inversione di contrasto è un fattore noto che scatena errori di lettura in quella tecnologia più vecchia, il che suggerisce che la preoccupazione di fondo sia ragionevole. Nessuno ha condotto il test equivalente sui modelli multimodali che oggi le persone usano per leggere uno screenshot di chat, almeno non in niente di quello che sono riuscito a trovare, quindi non affermerò un numero che non posso sostenere.
Le emoji stanno dentro la stessa immagine, e la ricerca su di loro risponde a una domanda diversa da quella che di solito viene posta. Riguarda meno il fatto che un modello riesca a capire che una forma è un’emoji, e più quale emoji stia guardando, perché lo stesso carattere non disegna la stessa immagine ovunque. Il Consorzio Unicode standardizza il code point e il suo significato, non la grafica. Apple, Google, Samsung e ogni altro fornitore disegnano il proprio glifo per quel carattere3. In un sondaggio su 710 utenti Twitter che avevano appena pubblicato un tweet con un’emoji, almeno il 25% non sapeva che la propria emoji potesse apparire diversa sul telefono di qualcun altro, e dopo che il sondaggio ha mostrato loro come uno dei propri tweet veniva effettivamente reso su un’altra piattaforma, il 20% ha detto che l’avrebbe modificato o non l’avrebbe mandato affatto3. Quel divario esiste già tra due persone che guardano lo stesso carattere su due telefoni diversi. Uno screenshot lo restringe ulteriormente. Fare lo screenshot appiattisce in un’immagine statica qualunque cosa la piattaforma di chi scrive abbia disegnato, e un modello che legge quell’immagine non può ricostruire quale emoji ci fosse in origine senza il font specifico della piattaforma già cotto dentro i pixel. Se questa combinazione, l’ambiguità tra piattaforme più la compressione dello screenshot, cambi quanto spesso un modello indica l’emozione sbagliata dietro un’emoji è un test che nessuno sembra aver ancora condotto.
Modalità di errore che le pagine di workflow di questo sito non coprono
Una manciata di funzioni specifiche delle chat rende la lettura corretta più difficile, ognuna a modo suo, oltre al problema a livello di pixel visto sopra. Alcune delle cose che seguono si basano su uno studio. Altre sono una semplice descrizione di come funziona l’interfaccia, senza nessuna ricerca dedicata alle spalle, e ho cercato di tenere le due cose separate, così una non prende in prestito il peso dell’altra.
Gruppi e thread con più partecipanti. Uno screenshot uno a uno dà a un modello due gruppi visivi in cui smistare il parlato, una parte e l’altra. Un thread di gruppo rompe questo schema. Tre o più persone possono condividere lo stesso colore di bolla, il nome di chi scrive può comparire solo sopra il primo messaggio di una serie e non su ogni riga successiva, e un avatar tagliato può essere l’unico indizio visivo su chi sta parlando. Non ho trovato uno studio che testi l’accuratezza di un modello nell’attribuire correttamente le righe dentro uno screenshot di chat di gruppo nello specifico. La ricerca più vicina misura un problema collegato ma diverso, l’attribuzione di chi parla in trascrizioni scritte di riunioni, non in bolle fatte di screenshot, e questo sito copre già quel terreno nella pagina su come leggere un intero thread di conversazione. Quello che c’è qui è una descrizione meccanica della versione a screenshot dello stesso problema, non un risultato testato. Più persone che parlano condividendo meno indizi visivi per riga è, a prima vista, un compito di attribuzione più difficile, che qualcuno l’abbia misurato o no quanto sia più difficile.
Reazioni rapide ed emoji di reazione. Una piccola emoji appuntata nell’angolo della bolla di qualcun altro, un cuore, una risata, un pollice in su, porta con sé due rischi separati. Il primo è se un modello riesca innanzitutto a identificare correttamente il piccolo glifo, a volte sovrapposto ad altri, di cui non ho trovato nessun test diretto. Il secondo è cosa significhi la reazione una volta letta correttamente, e i ricercatori hanno studiato questa parte. Un’analisi di oltre 650,000 messaggi Telegram con reazioni ha trovato che le reazioni positive dominavano le risposte indipendentemente dal fatto che il messaggio sottostante si leggesse come neutro o negativo, concludendo che le reazioni con emoji “non funzionano in modo affidabile come indicatori di rispecchiamento emotivo o di risonanza con il contenuto”4. È un campione ampio da una sola piattaforma e una sola area tematica, i canali legati alle criptovalute, e resta un preprint, quindi tratta le cifre precise come provvisorie. Il punto che conta per chi legge uno screenshot regge comunque, al netto di queste avvertenze. Identificare correttamente l’emoji della reazione non dice a nessuno, modello o persona, cosa segnali davvero quella reazione.
Risposte citate e interfaccia di threading. La maggior parte delle app di messaggistica ti permette di rispondere a un messaggio precedente specifico, mostrando il frammento citato come un blocco più piccolo e più tenue sopra quello nuovo. In uno screenshot, quel trattamento visivo, dimensione ridotta, colore più chiaro, a volte una riga verticale, è l’unico segnale che una riga è contesto citato e non un nuovo messaggio di chi sembra visivamente avere il turno. Ritaglia l’immagine con pochi pixel di differenza e la distinzione può sparire. Non ho trovato nessuno studio che misuri quanto spesso un modello scambi un frammento citato per un messaggio nuovo o viceversa. Questa è una modalità di errore meccanica plausibile, incorporata nel modo in cui l’interfaccia rappresenta il threading, non una modalità testata.
Messaggi che scompaiono ed effimeri. Le app di messaggi effimeri progettano i propri messaggi in modo che non lascino traccia una volta visualizzati, ed è esattamente questo che uno screenshot vanifica. Prima ancora che entri in gioco qualunque domanda sull’AI, i ricercatori forensi avevano già mostrato che la premessa di fondo è più fragile di quanto gli utenti diano per scontato. Testando direttamente le funzioni di messaggi che scompaiono di WhatsApp, Snapchat e Telegram, uno studio ha recuperato contenuti presumibilmente cancellati dai dati del dispositivo e dai backup cloud in diversi degli scenari provati5. Questo è un risultato sulle piattaforme, non sull’AI che legge uno screenshot di uno di quei messaggi, e non misura nulla sull’accuratezza di un modello. Quello che stabilisce, indipendentemente da qualsiasi AI, è che uno screenshot non è l’unico modo in cui un contenuto effimero sopravvive alla cancellazione prevista. Se lo sfocamento sullo schermo di un’app o un banner “screenshot rilevato” introducano artefatti visivi che un modello potrebbe scambiare per contenuto è, di nuovo, una preoccupazione plausibile, e non ho trovato nessuno studio dedicato.
Sticker. Uno sticker porta significato più attraverso la posa e l’espressione che attraverso le parole, il che lo rende una lettura più difficile per una macchina e, si scopre, anche per le persone. Uno studio su cinque gruppi di studenti che usavano sticker in chat di progetto reali, basato anche su interviste a sette dei partecipanti sul proprio uso degli sticker, ha trovato una discrepanza tra quello che intendeva chi lo mandava e quello che capiva chi lo riceveva nel 34.7% degli sticker esaminati, soprattutto per via di espressioni facciali e corporee ambigue nella grafica stessa6. È uno studio piccolo e qualitativo su una sola popolazione, studenti universitari di un’unica istituzione asiatica, e misura la lettura sbagliata delle persone, non quella di un modello. Resta comunque una prova reale che uno sticker è un segnale ambiguo anche tra persone che già si conoscono, il che fissa un soffitto basso su quanto dovresti aspettarti da qualsiasi lettore, umano o macchina, partendo solo dall’immagine.
Code-switching a metà conversazione. Cambiare lingua dentro un solo messaggio, o tra un messaggio e l’altro nello stesso thread, è comune in chi scrive messaggi in modo bilingue o plurilingue, ed è un caso difficile documentato per i modelli linguistici in generale. Una rassegna del 2025 sul campo afferma chiaramente che “la maggior parte degli LLM fatica ancora con input in più lingue mescolate”7, senza un numero che si trasferisca in modo pulito a uno screenshot con due lingue dentro una sola bolla di testo. Non sono riuscito a trovare uno studio che isoli il code-switching come problema specifico di lettura di screenshot, a parte il problema più ampio del testo plurilingue che la rassegna descrive. Trattalo come una difficoltà reale e documentata nella tecnologia di base, applicata qui a un caso che nessuno ha ancora testato direttamente.
Cosa dicono tre app per screenshot sul tuo caricamento
Subtext non è l’unica app costruita per leggere uno screenshot di chat, e il confronto utile è cosa dice la documentazione attuale di ciascuna che succede a un caricamento, non cosa lascia intendere il suo marketing. Il campo più ampio degli strumenti di scrittura AI è mappato a parte; qui ho controllato tre prodotti nominati lì, contro le loro stesse pagine sulla privacy, per una sola domanda ristretta, la conservazione, la cancellazione, e l’uso nell’addestramento di un modello.
Keys AI Texting Coach, costruita da Charmed Inc. attorno alla lettura di screenshot per consigli di dating e messaggistica, non sembra più essere online. Il servizio di ricerca iTunes di Apple restituisce zero risultati per la sua scheda sull’App Store, app id 1510154956, al 27 settembre 20268, e il suo dominio web noto reindirizza ogni percorso, compreso quello che un tempo ospitava la sua informativa sulla privacy, verso una pagina di parcheggio del dominio. Non sono riuscito a individuare un’informativa sulla privacy attuale per questa app attraverso nessun canale. Qualunque cosa dicesse un tempo sulla gestione degli screenshot, non posso verificarlo oggi, e non sto ricostruendo un’affermazione a partire da una pagina che non si carica più.
Mei, un’app di messaggistica predefinita per Android con un assistente AI opzionale, afferma nei suoi termini attuali, aggiornati l’ultima volta il 3 ottobre 2023 e controllati il 27 settembre 20269, che il contenuto dei messaggi, comprese “immagini, foto, audio o video”, viene conservato sui suoi server “al solo scopo della comunicazione” e “non viene usato da noi in nessun altro modo”. A parte, descrivendo cosa riceve davvero il suo assistente AI opzionale, lo stesso documento dice che gli ultimi 20 messaggi mandati all’AI come contesto includono “emoji, reazioni e URL”, ma che “i messaggi con allegati, i messaggi vocali e le immagini non vengono raccolti” per quello scopo. Letti insieme, i documenti stessi di Mei dicono che la sua funzione di suggerimento AI non elabora affatto contenuti immagine, screenshot compresi. La clausola sulla conservazione delle foto riguarda la normale consegna dei messaggi dentro l’app, non quello che viene mandato all’AI. Una funzione separata di assistente AI, opzionale, funziona in modo diverso. Quando un utente la attiva, Mei carica l’intero database dei messaggi SMS e MMS del dispositivo, incluso il testo di ogni messaggio, più i numeri di telefono con hash e i nomi dei contatti, e la policy afferma che quei dati vengono “usati per addestrare modelli di AI”. Quella clausola non nomina nello specifico screenshot o immagini, ma riguarda l’addestramento sul testo dei messaggi in generale, non solo sui metadati dei contatti.
L’informativa sulla privacy di ConfiText, in vigore dal 10 febbraio 2026 e controllata il 27 settembre 202610, affronta solo il “testo che inserisci nell’App” e non menziona foto, immagini o screenshot in nessuna delle sue nove sezioni. Il suo stesso sito di marketing descrive esattamente un metodo di input, incollare un messaggio che l’utente ha già scritto, e nessuna funzione di caricamento di screenshot o foto compare da nessuna parte sulla pagina. Allo stato attuale, la questione della conservazione non sembra applicarsi a ConfiText. Il prodotto, secondo il suo stesso sito attuale, non prende affatto uno screenshot come input.
Tra le tre, il conto è un’app che non sembra più esistere, una la cui documentazione esclude le immagini da quello che la sua AI legge davvero ma che addestra sul testo dei messaggi quando un utente attiva il suo assistente, e una che non accetta affatto uno screenshot. Questo non stabilisce come un’app che legge screenshot dovrebbe gestire la conservazione dei dati. Significa che confrontare le policy sugli screenshot di tre concorrenti nominati ha prodotto meno accordo, e meno applicabilità, di quanto la premessa presupponesse all’inizio.
Rimuovere i metadati, buon senso o qualcosa di verificato
Ogni foto scattata dalla fotocamera di un telefono può portare con sé dati EXIF, modello del dispositivo, timestamp, a volte la posizione, incorporati nel file. Il consiglio di rimuovere questi dati prima di condividere una foto è ovunque online. Ho cercato uno studio controllato che misurasse se rimuovere quei dati, o oscurare manualmente i contenuti visibili di uno screenshot, produca una riduzione misurabile del danno reale alla privacy, rispetto a un’esposizione teorica che una redazione chiude solo sulla carta. Non ne ho trovato uno. Quello che esiste è scrittura descrittiva sulla sicurezza che spiega quali campi esistono e come rimuoverli, non un esperimento che confronti i risultati tra chi ha rimosso i metadati e chi no. Tratta il consiglio come ragionevole e non testato, non come una protezione misurata.
Su cosa fa Subtext stesso con i metadati di uno screenshot, ho letto direttamente i system prompt e le definizioni degli strumenti del backend, lo stesso file che le regole di questo sito impongono di controllare prima di qualunque affermazione sul prodotto (functions/src/subtext_prompts.ts). Niente in quel codice legge, rimuove, ispeziona o tocca in altro modo i metadati del file di uno screenshot. Subtext consegna le immagini al modello con capacità di visione sottostante come input visivo, allo stesso modo di qualsiasi altra immagine, e nessun passaggio separato di elaborazione dei metadati compare da nessuna parte nei prompt o nelle definizioni degli strumenti che ho letto. Lo dico come un’assenza, non come una funzione. Non ho trovato nessuna prova che Subtext faccia qualcosa con i metadati di uno screenshot, in nessuna delle due direzioni, e non sto rivendicando una capacità che il codice non mostra. Non esiste nemmeno nessuna valutazione indipendente di quanto accuratamente Subtext stesso legga uno screenshot, la stessa lacuna che attraversa ogni app nominata sopra. Quello che l’informativa sulla privacy conferma, e quello che le due pagine di workflow di questo sito già affermano, è la regola generale che si applica a ogni allegato, screenshot compreso. Una conversazione, e qualsiasi cosa allegata a essa, si cancella da sola cinque giorni dopo l’ultimo utilizzo, o dopo 90 giorni se la fissi, e niente di quello che carichi viene usato per addestrare un modello di AI.
Due screenshot letti da Subtext, il caso facile
Niente di quello che c’è sopra è un test di Subtext, e nemmeno questo lo è. Sono due esempi, fatti il 21 ottobre 2026, sul tipo di screenshot che tutto quello che c’è sopra indica come il più facile: un thread uno a uno in italiano, in light mode, con caratteri grandi, senza emoji, senza reazioni e senza risposte citate. Entrambi i thread sono inventati e sono stati disegnati per questi esempi. Quello che l’app ha risposto è il suo output reale.
Il primo screenshot, datato oggi alle 18:42, è una chat con Dana. Lei chiede se la cena di venerdì è ancora confermata, dice di aver prenotato da Luigi’s per le 19:30, chiede se può venire anche Tom e chiede, senza fretta, il libro che ha prestato. Lo screenshot è entrato con la richiesta “Scrivi una breve risposta amichevole”. Subtext non ha scritto la risposta. Ha detto “Che bella serata in arrivo! Prima di scrivere la risposta ho due domande veloci, così non rispondo al posto tuo.” e sotto ha messo tre domande numerate: “Ti va bene che venga anche Tom?”, “E per il libro: lo porti venerdì?” e “C’è qualcos’altro che vuoi dirle o chiederle?”. Le prime due hanno risposte pronte da toccare, per esempio “Sì, volentieri” o “Preferirei di no” per Tom.
Scrivi una breve risposta amichevole
Che bella serata in arrivo! Prima di scrivere la risposta ho due domande veloci, così non rispondo al posto tuo.
- Ti va bene che venga anche Tom?
- E per il libro: lo porti venerdì?
- C'è qualcos'altro che vuoi dirle o chiederle?
Insieme a quella risposta il modello ha restituito delle note sul thread, che l’app conserva e non mostra. Una dice “Dana a user, oggi 18:42: ti va bene se viene anche Tom alla cena da Luigi’s venerdì alle 19:30? Ancora aperta”. L’altra registra allo stesso modo la domanda sul libro, compreso il “Nessuna fretta se non l’hai finito”, come ancora aperta. Tutto ciò che le note menzionano corrisponde all’immagine: Dana, le 18:42, venerdì, Luigi’s, le 19:30, entrambe le domande, e il fatto che a farle sia stata Dana. Delle altre righe del thread le note non dicono niente.
Il secondo screenshot è entrato con una bozza scritta invece che con una richiesta. Lì Priya disdice giovedì e promette di vedersi la settimana dopo. Oggi, quando le viene chiesto se stasera è confermato, con un tavolo prenotato per le 20, annulla di nuovo e chiede “Possiamo fare la settimana prossima?”. La bozza era “Certo, nessun problema. Quando hai tempo.”
Subtext ha segnato le parole “Quando hai tempo.” e ha restituito i tag Passivo-aggressivo e Messaggi contrastanti, con l’emozione Delusione. Il motivo dietro il primo tag dice che la frase “può suonare come un rimprovero velato dopo due annullamenti.” Il motivo dietro il secondo dice che “Nessun problema” e “quando hai tempo” lasciano la proposta aperta “e non chiariscono cosa senti davvero”. La sua prima versione, Vicina alla tua, dice “Certo, nessun problema. La settimana prossima va bene, dimmi tu quando.”
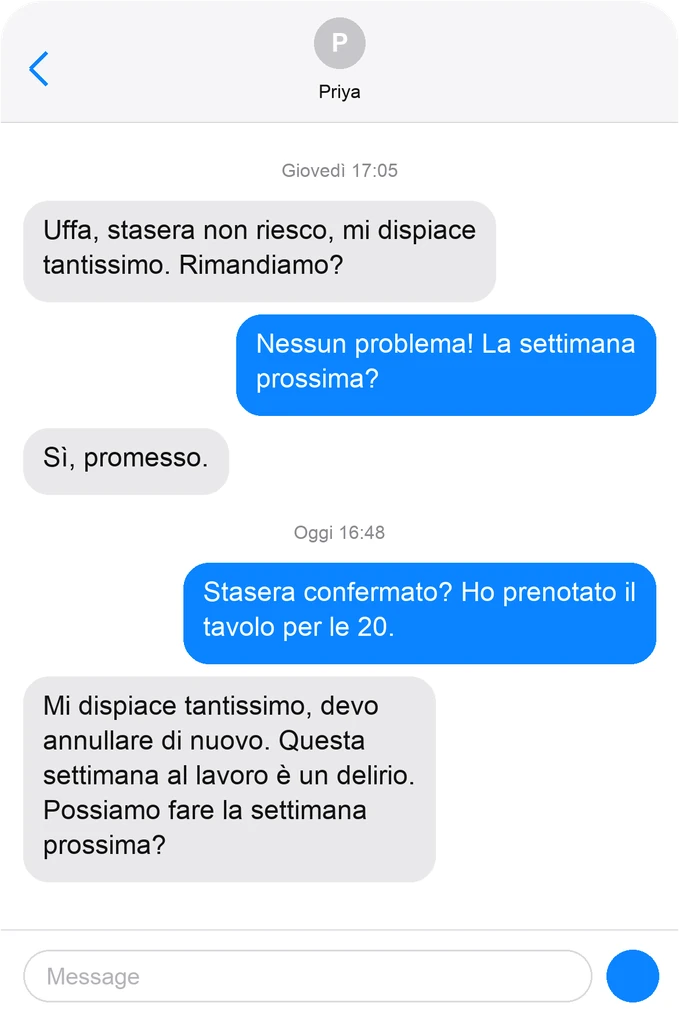
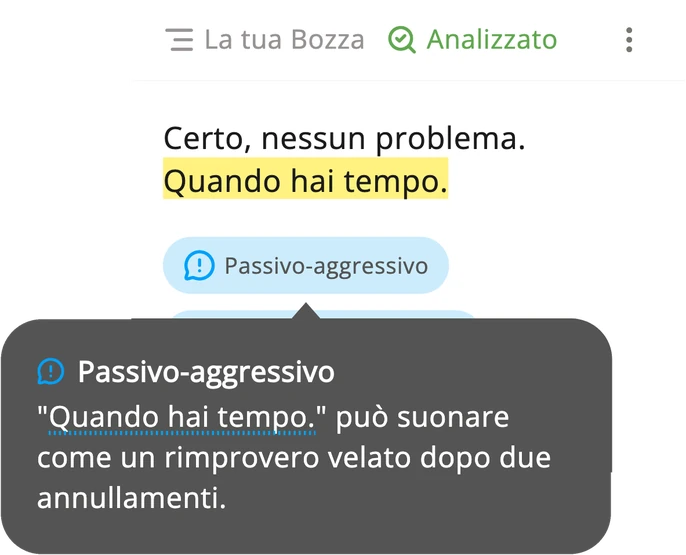
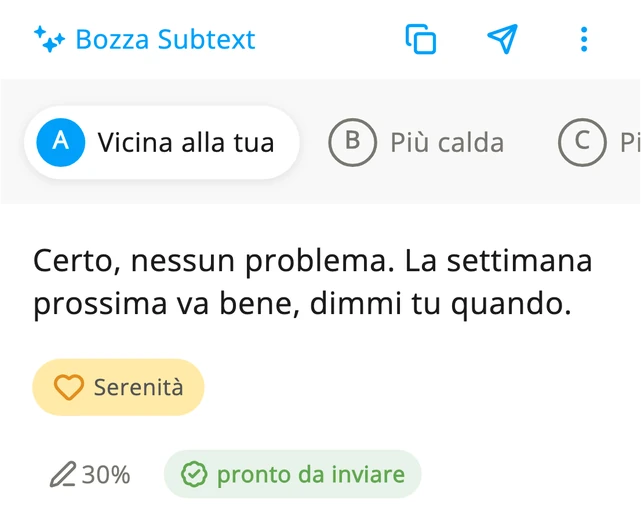
La lettura si basa sull’immagine e non solo sulla bozza: il motivo del primo tag sa che gli annullamenti sono due, la prima versione risponde alla domanda rimasta aperta alla fine del thread, e la nota dietro la seconda versione nomina il lavoro di Priya. Quindi, su due screenshot puliti, ogni dettaglio che Subtext ha ripreso dall’immagine le corrisponde. I due esempi non dicono niente sui caratteri piccoli o su un altro sistema di scrittura, dove i numeri pubblicati calano, né sul dark mode o su un thread di gruppo, che nessuno ha misurato.
Il quadro d’insieme
Lasciando da parte i due esempi e mettendo insieme le quattro parti viste sopra, il quadro è irregolare per costruzione, non per caso. L’unica parte con un numero di accuratezza reale e verificabile, la prestazione OCR generale dentro un modello con capacità di visione, è mista, forte in inglese, misurabilmente più debole sulle scritture non latine e sul testo a bassa risoluzione, testata su benchmark curati, non su veri screenshot di chat. Quattro delle sei modalità di errore extra viste sopra citano ricerca reale su una domanda adiacente, cosa segnali davvero una reazione una volta letta correttamente, quanto siano affidabili le app effimere nel cancellare i contenuti fin dall’inizio, quanto spesso le persone fraintendano a vicenda gli sticker, e quanto male i modelli linguistici gestiscano in generale il testo in più lingue. Nessuno di quei quattro studi ha testato il caso esatto di un modello che lo legge da uno screenshot. Gli altri due, l’attribuzione nelle chat di gruppo e la confusione delle risposte citate, non hanno nessuna ricerca alle spalle, né adiacente né di altro tipo, solo una descrizione meccanica di come funziona l’interfaccia. Il controllo sui concorrenti ha trovato meno da confrontare di quanto la premessa presupponesse, un’app sparita, una che esclude le immagini dalla propria funzione AI per sua stessa ammissione, una che non ha mai accettato screenshot. E la questione dei metadati si è rivelata un consiglio che tutti ripetono e che nessuno sembra aver misurato.
Niente di tutto questo significa che un modello che legge il tuo screenshot sia inaffidabile nell’uso generale. Lo studio più ampio e più diretto qui ha comunque misurato un modello che legge correttamente la maggior parte del testo di scena in inglese. Significa che l’affermazione specifica, cioè che un modello con capacità di visione legge uno screenshot di chat con la stessa affidabilità con cui legge testo digitato semplice, ha eccezioni reali e quantificate, alcune ampie, e diversi casi difficili che nessuno ha ancora misurato.
Le cose stanno così oggi. Subtext è un’altra app che fa questo, né più né meno verificata delle altre viste sopra. Prova Subtext nel browserScarica dall'App StoreDisponibile su Google PlayInquadralo con la fotocamera del telefono per installare l'app.
Fonti controllate il 27 settembre 2026. Esempi di Subtext, 21 ottobre 2026.
Fonti
- Shi, Peng, Liao, Lin, Chen, Liu, Zhang e Jin (2023). Exploring OCR Capabilities of GPT-4V(ision): A Quantitative and In-depth Evaluation. arXiv. Benchmark OCR su testo di scena e documenti confrontati con una sola generazione di modelli del 2023, non su screenshot di messaggistica.
- Inoue (2025). Context-Independent OCR with Multimodal LLMs: Effects of Image Resolution and Visual Complexity. arXiv preprint, autore singolo. Testa 100 caratteri kanji giapponesi isolati a dimensione del font e risoluzione controllate, non screenshot di chat.
- Miller Hillberg, Levonian, Kluver, Terveen e Hecht (2018). What I See is What You Don’t Get: The Effects of (Not) Seeing Emoji Rendering Differences across Platforms. Proceedings of the ACM on Human-Computer Interaction, CSCW. Sondaggio su 710 utenti Twitter sui propri tweet con emoji, non un test di un modello che li legge.
- Tardelli, Alvisi, Cima, Cresci e Tesconi (2025). Emoji Reactions on Telegram: Unreliable Indicators of Emotional Resonance. arXiv preprint. Oltre 650,000 reazioni su messaggi Telegram legati alle criptovalute, una sola piattaforma e una sola area tematica.
- Heath, MacDermott e Akinbi (2023). Forensic analysis of ephemeral messaging applications: Disappearing messages or evidential data? Forensic Science International: Digital Investigation. Testa il comportamento di cancellazione proprio di WhatsApp, Snapchat e Telegram, non la lettura di uno screenshot da parte dell’AI.
- Tang, Hew, Herring e Chen (2021). (Mis)communication through stickers in online group discussions: A multiple-case study. Discourse & Communication. Cinque gruppi di discussione e sette intervistati in un’unica università; misura la lettura sbagliata delle persone, non quella di un modello.
- Sheth, Sinha, Patil, Beniwal e Singh (2025). Beyond Monolingual Assumptions: A Survey of Code-Switched NLP in the Era of Large Language Models across Modalities. arXiv preprint survey, nessun test specifico sugli screenshot.
- Apple. iTunes Lookup API result for Keys AI Texting Coach, app id 1510154956, controllato il 27 settembre 2026. Zero risultati restituiti; l’app non sembra più essere in elenco.
- Mei. Terms of Service and Privacy Policy, aggiornati l’ultima volta il 3 ottobre 2023, controllati il 27 settembre 2026.
- ConfiText. Privacy Policy, in vigore dal 10 febbraio 2026, controllata il 27 settembre 2026.