ArticlesMessages
Qu'est-ce qui fait qu'une réponse fait mouche ?
Une réponse fait mouche quand elle montre que vous vous êtes vraiment engagé avec ce message précis, venant de cette personne précise. La vitesse compte bien moins qu'on ne le pense, et une réponse rapide mais générique s'est révélée pire qu'une réponse lente.
Par Samet Durgun · Cofondateur de Subtext · 14 min de lecture
· Mis à jour le 14 octobre 2026
La plupart des conseils sur les réponses parlent en réalité de vitesse. Répondez dans les cinq minutes, répondez dans l’heure, ne laissez pas passer trois jours. J’ai cofondé Subtext et je passe le plus clair de mon temps à regarder des messages sur lesquels les gens restent bloqués, et la vitesse n’est presque jamais ce qui cloche.
La recherche pointe ailleurs, et elle pointe toujours dans la même direction. Ce qui fait qu’une réponse fonctionne, c’est qu’elle démontre que vous vous êtes engagé avec ce message précis, venant de cette personne précise. Les psychologues appellent ça la réactivité perçue, c’est-à-dire le sentiment d’avoir été compris, validé et choyé. C’est le mécanisme mesuré dans la recherche sur le fait de poser des questions, le mécanisme dans la recherche sur la concrétude du langage, ce qui détermine si un soutien aide ou blesse, et ce que le soupçon d’IA détruit. Tout le reste de cet article n’est qu’une autre façon de résoudre ce même problème.
La vitesse compte moins que vous ne le pensez, sauf quand ce n’est pas le cas
Deux situations différentes, et les mélanger produit de mauvais conseils.
Avec des inconnus, dans une transaction, la vitesse, c’est de l’argent réel. Hart, VanEpps, Sezer et Amir ont combiné des données de transactions issues d’une plateforme freelance, couvrant environ 11,66 millions de demandes de service, avec des expériences totalisant plusieurs milliers de participants1. Des délais d’à peine cinq à dix minutes réduisaient de façon mesurable les chances de décrocher le contrat. Le mécanisme qu’ils identifient est inférentiel. Une réponse rapide signale que vous serez probablement réactif plus tard aussi. Il faut cependant garder les deux moitiés séparées. Les données de la plateforme sont des données de terrain corrélationnelles. Le mécanisme, lui, vient de la partie expérimentale.
Avec des collègues, l’erreur va dans l’autre sens. Giurge et Bohns ont documenté un biais d’urgence par e-mail sur huit études préenregistrées portant sur 4 004 actifs2. Les destinataires surestiment la rapidité à laquelle les expéditeurs attendent une réponse à un e-mail non urgent envoyé hors des heures de travail, et ils le paient en stress. Une seule ligne de l’expéditeur précisant qu’il n’y a pas d’urgence réduisait ce biais. Des travaux connexes définissent la télépression au travail, cette envie irrépressible de répondre immédiatement, et la relient à un moins bon rétablissement, à l’épuisement professionnel et à un sommeil dégradé3.
Le conflit est l’une des exceptions. Quand Huang et Yao ont demandé à 162 étudiants d’Austin d’imaginer un partenaire qui tarde à répondre pendant une dispute, les étudiants attendaient une réponse en dix minutes environ, contre dix-neuf un jour ordinaire. Ceux qui attendaient des réponses plus rapides vivaient plus mal le retard4. C’était un scénario imaginé, avec des étudiants, et il ne mesurait que le ressenti négatif.
Et le silence veut dire ce que la norme entre vous voulait déjà dire. Kalman et Rafaeli ont testé la latence de réponse comme une violation des attentes, et ont trouvé que l’effet du délai dépendait de la façon dont les gens percevaient déjà l’expéditeur5. Les évaluateurs pardonnaient une réponse lente venant d’un candidat prometteur, mais la reprochaient à un candidat plus faible. Ce que le silence signifie pour la personne qui attend est une autre question, que j’aborde dans ce que signifie le fait que quelqu’un lise votre message sans répondre. Deux heures de la part de quelqu’un qui répond toujours en cinq minutes n’est pas le même signal que deux heures de la part de quelqu’un qui répond deux fois par jour, et aucune règle fondée sur l’horloge ne peut capter ça.
Le résultat qui redéfinit la question de la vitesse
Lew, Walther, Pang et Shin ont mené l’expérience que tout le monde devrait connaître, et que presque personne ne connaît6.
Ils ont fait varier deux choses indépendamment. La première était la rapidité d’arrivée de la réponse, huit secondes contre quarante. La seconde était de savoir si la réponse était contingente, c’est-à-dire adaptée à ce que la personne venait de demander, par opposition à une réponse générique toute faite. 131 adultes américains ont regardé un chat de service client simulé et l’ont évalué sur quatre critères.
La vitesse n’a produit aucun effet principal significatif sur aucun des quatre. La contingence a produit des effets significatifs sur les quatre, avec des tailles d’effet allant de 0,48 à 0,66.
Les auteurs avaient prédit que les réponses lentes et génériques seraient les pires. Ils se trompaient, et ils le disent eux-mêmes. Les réponses rapides et génériques ont obtenu les scores les plus bas sur tous les critères. Leur explication est qu’une réponse rapide qui ne s’engage pas avec le contenu paraît robotique, et que sans un délai suggérant que la personne est occupée, elle se lit au mieux comme de l’inattention.
Le message pratique que je retiens de toute cette littérature, c’est que se précipiter pour envoyer quelque chose de vide est pire que de prendre son temps pour envoyer quelque chose de réel.
Une réponse rapide et vide n’a pas l’air fausse à l’écran. Elle a l’air efficace. Le problème ne devient visible que lorsqu’on se demande ce qu’elle produit chez la personne qui la lit.
La seule tactique qui se généralise
Posez une question de relance sur ce qu’ils viennent de dire.
Huang, Yeomans, Brooks, Minson et Gino ont mené trois études sur des conversations en direct7. Dans une étude de chat en ligne portant sur 199 dyades, les personnes à qui l’on demandait de poser beaucoup de questions étaient significativement plus appréciées, et la réactivité perçue médiait l’effet. Une deuxième étude a répliqué le résultat et rattaché l’effet spécifiquement aux questions de relance, c’est-à-dire des questions qui ne pouvaient venir que d’avoir vraiment lu la réponse. Un volet speed dating a trouvé que le taux de questions de relance prédisait les propositions de second rendez-vous.
Trois précisions sur cet article, parce qu’il est contesté et que ça compte. Il existe une controverse publiée. Kluger et Malloy ont réanalysé l’étude de speed dating et avancé que l’effet disparaît une fois qu’on tient compte de qui posait les questions, et les auteurs d’origine ont répondu que cette réanalyse utilisait la mauvaise mesure et un modèle inadapté8. Je dirais que les expériences de conversation constituent l’appui le plus solide, et le volet speed dating la partie contestée. L’article fait l’objet d’une correction publiée en mars 2025, sans expression de préoccupation ni rétractation. Et une étude tierce, contenue dans le même article, a trouvé que des observateurs lisant les transcriptions ne partageaient pas cette préférence, ce qui constitue une vraie limite.
Séparément, les gens évitent de poser des questions sensibles parce qu’ils craignent de vexer, et ils surestiment significativement ce coût9. Qu’il s’agisse de la question de relance évidente ou de la question sensible, la question que vous n’osez pas poser est probablement sans danger à poser.
Nommez la chose précise
Packard et Berger ont isolé la concrétude du langage comme un signal d’écoute10. Cinq études, dont une analyse textuelle de plus de 1 000 interactions clients réelles, menée dans deux contextes de terrain. Les clients étaient plus satisfaits, plus disposés à acheter, et dépensaient davantage lorsque la personne qui répondait utilisait un langage concret, et le mécanisme tenait au fait qu’ils en déduisaient que l’employé était attentif. Une augmentation d’un écart type de la concrétude améliorait la satisfaction de 9 % et les dépenses d’au moins 13 %.
Je trouve que la traduction pratique est étonnamment nette. « Ce t-shirt gris », pas « ton problème ». « La réunion de jeudi », pas « le truc dont tu m’as parlé ». Nommer l’objet précis, c’est ce qui se lit comme de l’écoute, et ça ne coûte rien. C’est aussi la chose la plus facile à vérifier mécaniquement.
S’il s’agit d’une conversation difficile, appelez
C’est le résultat le plus citable de tout ce corpus, et il va vous agacer.
Bevis, Schroeder et Yeomans ont mené des expériences randomisées avec 1 576 partenaires de conversation répartis sur 1 842 conversations, plus 1 432 observateurs11. Les conversations parlées produisaient une meilleure compréhension perçue et un conflit perçu plus faible que les conversations écrites, ainsi qu’une plus grande sympathie, plus de plaisir et un changement d’attitude plus marqué. En regroupant leurs trois premières études, parler augmentait la compréhension d’un bêta standardisé de 0,45 et réduisait le conflit de 0,23.
Puis ils ont demandé aux gens ce qu’ils choisiraient. 83,9 % préféraient écrire lorsqu’ils anticipaient un désaccord, et prédisaient que l’écrit produirait moins de conflit et plus de compréhension. Leurs expériences ont trouvé l’inverse.
Il y a un rebondissement qui sauve cet article de l’inutilité. Le langage réceptif, c’est-à-dire nuancer ses affirmations, reconnaître le point de vue de l’autre avant de le contester, et nommer les points d’accord réels, prédisait des issues plus constructives, et ce plus fortement à l’écrit qu’à l’oral12. Les auteurs voient une énigme dans le fait que les gens utilisent moins de langage réceptif précisément dans le média où il semble compter le plus.
Donc si vous devez l’écrire, les gestes de réceptivité comptent plus qu’ils ne compteraient au téléphone. Si vous avez le choix, l’appel se passe mieux que vous ne l’anticipez.
Réserves formulées par les auteurs eux-mêmes : les participants étaient pour la plupart des inconnus les uns pour les autres, le conflit était faible dans toutes les conditions, et la plupart étaient des étudiants. Deux personnes qui se connaissent bien et se disputent sur quelque chose de central dans leur relation pourraient se comporter différemment.
Les réponses d’attente, et pourquoi le conseil évident a besoin d’une condition
Je n’ai trouvé aucune expérience qui teste directement un court « bien reçu, je réponds correctement bientôt » contre une réponse complète mais différée, sans rien entre les deux. Le mécanisme est cependant bien étayé, donc je traiterais ça comme un raisonnement plutôt que comme un résultat.
L’incertitude sur le fait même que vous alliez répondre est ce que la recherche sur la latence identifie comme la partie dommageable1. Une réponse d’attente s’attaque précisément à ça. Giurge et Bohns ont montré qu’une brève note fixant les attentes réduisait une mauvaise lecture bien documentée2.
Mais Lew et ses collègues y mettent une condition6. Une réponse d’attente générique est une réponse rapide et non contingente, exactement la combinaison qui a obtenu le plus mauvais score des quatre dans leur étude. Les deux vous achètent le même sursis de quelques jours. Une seule des deux nomme quelque chose.
Générique « Merci pour votre message, nous revenons vers vous »
Rapide et non contingente, exactement la combinaison qui a obtenu le plus mauvais score sur chaque critère dans l’étude de Lew et ses collègues6
Précise « J’ai bien lu le passage sur le calendrier, il me faut jusqu’à jeudi pour répondre correctement »
Là où l’IA entre en jeu
Il vaut la peine d’être précis ici, puisque les preuves sont plus intéressantes que ce que disent aussi bien les enthousiastes que les critiques.
Rubin et ses collègues ont mené neuf études avec 6 282 participants13. Chaque réponse était générée par IA. C’est l’étiquette qui variait, les chercheurs présentant certaines réponses comme écrites par un humain et d’autres comme écrites par une IA. Les participants jugeaient les réponses étiquetées humaines plus empathiques et plus soutenantes, et ces réponses produisaient plus d’émotion positive. Le simple soupçon spontané d’un participant, sans qu’on le lui suggère, qu’une IA avait aidé à écrire une réponse étiquetée humaine, réduisait lui aussi l’empathie perçue. Le résultat se répliquait selon différentes longueurs, différents délais et différents modèles, et les réponses qui mettaient l’accent sur le partage émotionnel plutôt que sur la compréhension pratique en étaient le moteur.
Il faut lire le protocole avec attention, parce que c’est lui qui détermine ce que le résultat signifie vraiment. C’est une preuve qui porte sur l’attribution et la croyance. Ce n’est pas une preuve que l’IA écrit de moins bons messages, puisque c’est l’IA qui les a tous écrits. Je reviens sur d’autres de ces études dans si les outils de reformulation de messages par IA fonctionnent vraiment.
Un schéma similaire apparaît ailleurs. Dans deux expériences randomisées portant sur 1 020 participants, les réponses suggérées automatiquement augmentaient l’efficacité et le langage positif, et les participants qui croyaient que leur partenaire les utilisait jugeaient ce partenaire moins coopératif, une fois l’usage réel contrôlé14. C’est la croyance qui portait la sanction, pas l’usage. Et une étude antérieure sur des profils écrits par IA a trouvé que la confiance était similaire quand tout était écrit par IA ou quand tout était écrit par un humain, et ne chutait que lorsque les gens devaient deviner15.
Il existe ici un contre-résultat, et je ne vais pas le lisser. Ovsyannikova, Oldemburgo de Mello et Inzlicht ont trouvé que des évaluateurs tiers percevaient l’IA comme plus compatissante que des humains experts, et que ça tenait même quand les évaluateurs savaient qu’il s’agissait d’IA16. Les deux résultats ne se réconcilient pas simplement. La différence tient peut-être à la distinction entre évaluer l’échange de quelqu’un d’autre et recevoir soi-même un message.
Je mettrais directement en regard une autre étude sur la sanction liée aux réponses suggérées décrite plus haut, parce qu’elle a trouvé l’inverse. Mieczkowski et ses collègues ont fait échanger des messages à des participants, l’un des deux côtés utilisant des réponses suggérées automatiquement, et les destinataires n’ont pas jugé moins chaleureux ni moins compétents les expéditeurs qui s’en servaient17. Rapprochées de la sanction de la source 14, qui tenait à la seule croyance, les deux études aboutissent par des côtés différents à la même conclusion, à savoir que l’aide réelle de l’IA n’est pas nettement sanctionnée, alors que le soupçon qu’un partenaire sous-traite l’effort l’est.
Liu, Mittal, Yang et Bruckman ont testé ce soupçon directement, avec trois types d’e-mails, une demande de renseignements sur un produit, une invitation à une fête et un message pour consoler un ami dont l’animal était mort, chacun présenté comme écrit par une IA18. La confiance baissait à mesure que la part attribuée à l’IA augmentait, et elle baissait le plus pour l’e-mail émotionnel, ce que les auteurs attendaient dès le départ. Ce qu’ils n’avaient pas prévu, c’est que la confiance augmente, et ne baisse pas, quand l’enjeu relationnel était plus fort, si bien que le message de consolation attribué à l’IA inspirait malgré tout plus confiance que la demande de renseignements attribuée à l’IA. Leur propre hypothèse prévoyait l’ordre inverse. Interrogés ensuite, les dix participants ont tous déclaré sans nuance qu’ils ne voudraient pas qu’une IA écrive quoi que ce soit d’émotionnel à leur place, ce qui ne correspondait pas à ce que leurs propres notes venaient de montrer. Ce que les gens disent accepter et ce qui fait bouger leur confiance ne sont pas la même chose ici.
Khadpe et ses collègues ont trouvé le mécanisme qui sous-tend ces deux résultats. La mention d’une aide de l’IA fait baisser l’évaluation d’un message, et elle atténue aussi ce que le message apprend au lecteur sur le caractère de l’expéditeur, dans les deux sens. Un message chaleureux paraît moins chaleureux une fois étiqueté, et un message froid paraît moins froid19. L’étiquette vous coûte donc un peu de crédit côté chaleur, mais surtout, le message cesse de compter comme une preuve de qui vous êtes.
En dirigeant un produit dans cette catégorie, j’en retiens que ce qui aide, c’est de vous aider à écrire quelque chose qui reste le vôtre, et ce qui nuit, c’est une réponse qui se lit comme sous-traitée. Ça rejoint exactement le même point que tout le reste de cet article. Une réponse fonctionne quand elle démontre que vous vous êtes engagé, et rien de ce qui saute l’étape de l’engagement ne survit au contact de la personne qui le lit.
Subtext part de ce que vous avez écrit plutôt que de le remplacer, et vous montre à quel point ça a changé. Ce choix de conception est le seul que les preuves soutiennent, pas une posture marketing.
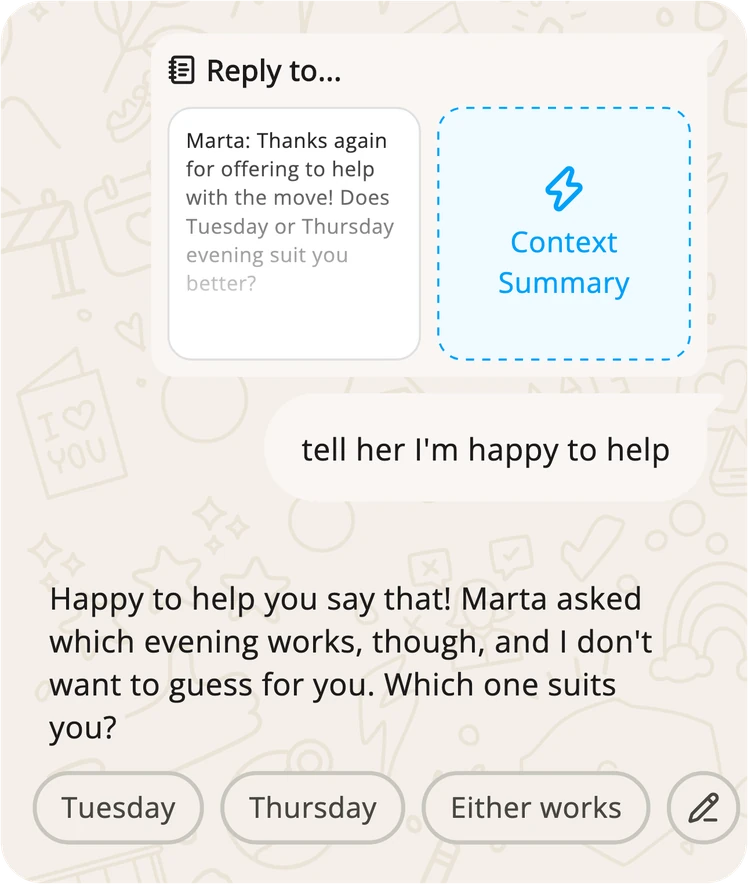
Subtext est aussi conçu pour ne pas deviner à votre place. Face à un message de Marta, inventé pour l’essai, « Thanks again for offering to help with the move! Does Tuesday or Thursday evening suit you better? » (merci encore de m’avoir proposé ton aide pour le déménagement, mardi ou jeudi soir, qu’est-ce qui t’arrange le mieux ?), et à la demande « tell her I’m happy to help » (dis-lui que je suis content d’aider), il n’a écrit aucune version. Il a répondu « Happy to help you say that! Marta asked which evening works, though, and I don’t want to guess for you. Which one suits you? » (je vous aide volontiers à le dire, mais Marta a demandé quel soir vous convient, et je ne veux pas deviner à votre place : lequel vous arrange ?) et a proposé trois réponses à choisir d’un toucher, Tuesday, Thursday et Either works (mardi, jeudi, les deux me vont). Une réponse construite à partir de la seule demande aurait sauté sa question. Avec la réponse Thursday, la première version qu’il a écrite disait « Happy to help! Thursday evening works well for me. » (avec plaisir, jeudi soir me convient bien). C’est une sortie réelle, telle que l’app l’a renvoyée.
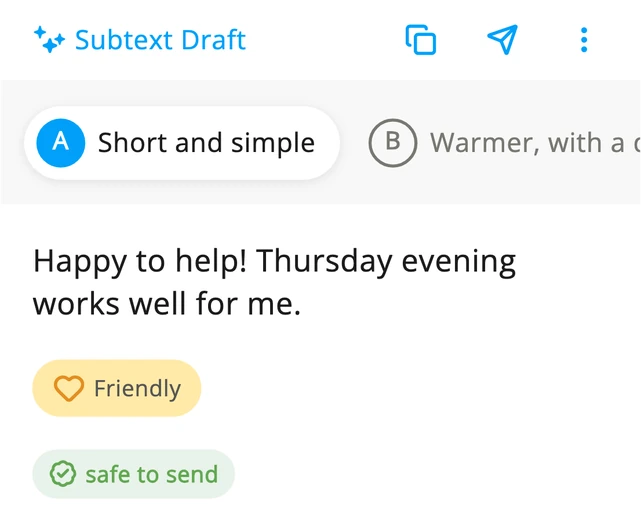
Subtext peut vous aider à nuancer, à reconnaître et à nommer l’accord, et il vous dira si une réponse d’attente est du genre générique ou du genre précis, puisque les deux se ressemblent mais n’obtiennent pas du tout le même score. Il ne travaille jamais que sur ce que vous écrivez, donc l’argument en faveur de décrocher le téléphone à la place vous revient.
Essayer Subtext dans votre navigateurDisponible sur l'App StoreDisponible sur Google PlayScannez-le avec l'appareil photo de votre téléphone pour installer.
À quoi ça ressemble selon le contexte
Le problème sous-jacent est le même partout. La façon de le résoudre diffère assez pour induire en erreur si vous généralisez.
- Travail et commercial. Avec des inconnus dans une transaction, la vitesse pèse réellement. Avec des collègues, l’erreur documentée est de surestimer l’urgence. Des détails concrets et une prochaine étape claire portent leurs fruits partout.
- Rencontres amoureuses. Ici, le timing envoie un signal, d’une façon qui n’existe pas ailleurs, et il obéit à un optimum courbe, pas à une règle fixe. Un texto envoyé après un délai modéré suite à un premier rendez-vous surpassait à la fois un envoi immédiat et un long délai, et la même étude n’a trouvé aucun appui pour un mécanisme de type se faire désirer20.
- Soutien. La réactivité est tout l’enjeu, et un soutien non réactif peut être pire que pas de soutien du tout. Maisel et Gable ont trouvé, dans une étude portant sur 67 couples cohabitants, que le soutien n’aidait que lorsqu’il correspondait à ce dont la personne avait besoin21. Quand la nouvelle est mauvaise, je traite séparément ce qu’il faut dire quand on ne sait pas quoi dire.
- Conflit. Nuancez, reconnaissez, nommez les points d’accord réels, et si vous le pouvez, décrochez le téléphone. Une fois la dispute passée, ce qu’il faut écrire après une dispute est une question différente.
C’est pourquoi Subtext lit le message qui se trouve devant lui et n’applique pas une règle unique partout. Ce à quoi ressemble « s’être engagé » dans un fil professionnel et dans un texto de premier rendez-vous, ce n’est pas la même chose, même si le problème sous-jacent, lui, l’est.
Des règles qui ne reposent sur rien
La règle des cinq minutes pour répondre à un prospect. L’affirmation selon laquelle répondre dans les cinq minutes multiplierait la conversion par 21 remonte à des livres blancs publiés par des fournisseurs commerciaux. La recherche sous-jacente sur la vitesse de réponse et les contrats, elle, est réelle1. Le multiplicateur ne l’est pas.
Le délai de trois heures pour un texto de rencontre. Je n’ai trouvé aucun appui empirique, et l’étude la plus proche du sujet a explicitement échoué à trouver le mécanisme de rareté qu’il lui faudrait pour tenir20.
Les repères sur les e-mails professionnels et les chiffres sur les attentes en service client. Largement diffusés, sourcés à des communiqués de presse d’entreprises et des rapports de fournisseurs, sans échantillons divulgués.
« 31 % des gens considèrent le texto comme une source quotidienne d’anxiété. » La source est un blog commercial, et je n’ai pas réussi à remonter jusqu’à une étude.
Sources
Numérotées dans l’ordre d’apparition ci-dessus. Quand un chiffre n’a pas pu être vérifié auprès de la source primaire, le texte le signale. Vérifié le 28 août 2026.
- Hart, E., VanEpps, E. M., Sezer, O., et Amir, O. (2026). Speed Is a Signal: When Faster Replies Increase Hiring Likelihood. Management Science, publié en ligne le 3 juin 2026.
- Giurge, L. M., et Bohns, V. K. (2021). “You don’t need to answer right away!” Organizational Behavior and Human Decision Processes, 167, 114 à 128.
- Barber, L. K., et Santuzzi, A. M. (2015). Please respond ASAP: Workplace telepressure and employee recovery. Journal of Occupational Health Psychology, 20(2), 172 à 189.
- Huang, Q., et Yao, S. (2024). No response? Chronemic expectancy violation and relational turbulence in technologically-mediated romantic relational conflict. Journal of Social and Personal Relationships, 41(5), 1183 à 1206. 200 étudiants âgés de 18 à 23 ans d’une université publique d’Austin, 162 analysés. Non préenregistrée, sans financement.
- Kalman, Y. M., et Rafaeli, S. (2011). Online Pauses and Silence: Chronemic Expectancy Violations in Written Computer-Mediated Communication. Communication Research, 38(1), 54 à 69.
- Lew, Z., Walther, J. B., Pang, A., et Shin, W. (2018). Interactivity in Online Chat: Conversational Contingency and Response Latency in Computer-Mediated Communication. Journal of Computer-Mediated Communication, 23(4), 201 à 221. 131 adultes américains, âge moyen 51,32.
- Huang, K., Yeomans, M., Brooks, A. W., Minson, J., et Gino, F. (2017). It Doesn’t Hurt to Ask: Question-Asking Increases Liking. Journal of Personality and Social Psychology, 113(3), 430 à 452. Fait l’objet d’une correction publiée en mars 2025, sans expression de préoccupation ni rétractation associée. Données sur osf.io/8k7rf.
- Kluger, A. N., et Malloy, T. E. (2019). Journal of Personality and Social Psychology, 117(6), 1132 à 1138, avec la réponse des auteurs dans Yeomans, Brooks, Huang, Minson et Gino (2019), 117(6), 1139 à 1144.
- Hart, E., VanEpps, E. M., et Schweitzer, M. E. (2021). The (better than expected) consequences of asking sensitive questions. Organizational Behavior and Human Decision Processes, 162, 136 à 154.
- Packard, G., et Berger, J. (2021). How Concrete Language Shapes Customer Satisfaction. Journal of Consumer Research, 47(5), 787 à 806.
- Bevis, B., Schroeder, J., et Yeomans, M. (2026). Spoken disagreement is more constructive than written disagreement. Nature Communications, 17, article 5792. Accès libre ; préenregistrements et données sur OSF.
- Yeomans, M., Minson, J., Collins, H., Chen, F., et Gino, F. (2020). Conversational receptiveness: Improving engagement with opposing views. Organizational Behavior and Human Decision Processes, 160, 131 à 148.
- Rubin, M., Li, J., Zimmerman, F., Ong, D. C., Goldenberg, A., et Perry, A. (2025). Comparing the value of perceived human versus AI-generated empathy. Nature Human Behaviour, 9(11), 2345 à 2359. Neuf études, 6 282 participants ; toutes les réponses étaient générées par IA, seule l’étiquette variait.
- Hohenstein, J., Kizilcec, R. F., DiFranzo, D., et al. (2023). Artificial intelligence in communication impacts language and social relationships. Scientific Reports. Deux expériences randomisées, 1 020 participants.
- Jakesch, M., French, M., Ma, X., Hancock, J. T., et Naaman, M. (2019). AI-Mediated Communication: How the Perception that Profile Text was Written by AI Affects Trustworthiness. CHI 2019. 527 participants.
- Ovsyannikova, D., Oldemburgo de Mello, V., et Inzlicht, M. (2025). Third-party evaluators perceive AI as more compassionate than expert humans. Communications Psychology, 3(1), 4. Va à l’encontre de la source 13 ; les deux sont mentionnées ici plutôt que réconciliées.
- Mieczkowski, H., Hancock, J. T., Naaman, M., et Jung, M. F. (2021). AI-Mediated Communication: Language Use and Interpersonal Effects in a Referential Communication Task. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), article 17.
- Liu, Y., Mittal, A., Yang, D., et Bruckman, A. (2022). Will AI Console Me when I Lose my Pet? Understanding Perceptions of AI-Mediated Email Writing. CHI 2022. Trois scénarios d’e-mail à enjeu relationnel croissant (une demande de renseignements sur un produit, une invitation à une fête et le réconfort d’un ami après la mort de son animal) ; dix entretiens de suivi.
- Khadpe, P., Wenzel, D., Loewenstein, G., et Kaufman, G. (2025). Explaining the Reputational Risks of AI-Mediated Communication: Messages Labeled as AI-Assisted Are Viewed as Less Diagnostic of the Sender’s Moral Character. Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society, 8, 1413 à 1423.
- Teichmann, F., Petrowsky, H. M., Boecker, L., Soliman, M., et Loschelder, D. D. (2026). Journal of Social and Personal Relationships. Effet de timing courbe après un premier rendez-vous ; aucun appui trouvé pour un mécanisme de rareté.
- Maisel, N. C., et Gable, S. L. (2009). The Paradox of Received Social Support: The Importance of Responsiveness. Psychological Science, 20(8), 928 à 932. 67 couples cohabitants.