ArtículosMensajes
¿Qué hace que una respuesta caiga bien?
Una respuesta cae bien cuando demuestra que te involucraste con ese mensaje específico de esa persona específica. La velocidad importa mucho menos de lo que la gente piensa, y en los estudios, una respuesta rápida pero genérica salió peor evaluada que una lenta.
Por Samet Durgun · Cofundador de Subtext · 14 min de lectura
· Actualizado el 14 de octubre de 2026
Casi todos los consejos sobre cómo responder son en realidad consejos sobre velocidad. Contesta en cinco minutos, contesta en una hora, no lo dejes tres días. Cofundé Subtext y paso la mayor parte de mi tiempo viendo mensajes en los que la gente se queda atorada, y la velocidad casi nunca es lo que está mal en ellos.
La investigación apunta hacia otro lado, y apunta ahí de forma consistente. Lo que hace que una respuesta funcione es si demuestra que te involucraste con este mensaje en particular, de esta persona en particular. Los psicólogos lo llaman capacidad de respuesta percibida, es decir, la sensación de haber sido entendido, validado y de que a alguien de verdad le importas. Es el mecanismo medido en la investigación sobre hacer preguntas, el mecanismo en la investigación sobre concreción, lo que decide si el apoyo ayuda o hace daño, y lo que la sospecha de que hay IA de por medio destruye. Todo lo demás en este artículo es otra manera de resolver ese mismo problema.
La velocidad importa menos de lo que crees, salvo cuando no
Son dos situaciones distintas, y mezclarlas produce malos consejos.
Con desconocidos, en una transacción, la velocidad es dinero de verdad. Hart, VanEpps, Sezer y Amir combinaron datos de transacciones de un mercado freelance que cubren cerca de 11.66 millones de solicitudes de servicio con experimentos que sumaron varios miles de participantes1. Demoras de apenas cinco a diez minutos redujeron de forma medible la probabilidad de ganar el contrato. El mecanismo que identifican es inferencial. Una respuesta rápida señala que probablemente también serás responsivo después. Aun así, conviene mantener las dos mitades separadas. Los datos del mercado son datos de campo correlacionales. El mecanismo es la parte experimental.
Con colegas, el error va al revés. Giurge y Bohns documentaron un sesgo de urgencia en el correo electrónico a lo largo de ocho estudios preregistrados con 4,004 adultos trabajadores2. Quienes reciben el correo sobreestiman qué tan rápido espera el remitente una respuesta a un correo no urgente fuera de horario, y lo pagan en estrés. Una sola línea del remitente diciendo que no hay prisa redujo el sesgo. Trabajo relacionado define la telepresión laboral, el impulso de contestar de inmediato, y la vincula con peor recuperación, agotamiento y sueño3.
El conflicto es una de las excepciones. Cuando Huang y Yao les pidieron a 162 estudiantes de Austin que imaginaran a su pareja contestando tarde durante una pelea, los estudiantes esperaban una respuesta en unos diez minutos, contra diecinueve en un día cualquiera. Quienes esperaban respuestas más rápidas se sintieron peor por la demora4. Era un escenario imaginado con estudiantes, y solo midió sentimientos negativos.
Y el silencio significa lo que ya era la norma entre ustedes. Kalman y Rafaeli probaron la latencia de respuesta como una violación de expectativas, y encontraron que el efecto de la demora dependía de cómo ya veía la gente a quien la enviaba5. Los evaluadores perdonaban una respuesta lenta en un candidato prometedor a un puesto, y la usaban en contra de uno más débil. Lo que el silencio significa para quien está esperando es otra pregunta aparte, que trato en qué significa que alguien lea tu mensaje y no conteste. Dos horas de parte de alguien que siempre contesta en cinco minutos es una señal distinta a dos horas de alguien que contesta dos veces al día, y ninguna regla basada en el reloj capta eso.
El hallazgo que replantea la pregunta sobre la velocidad
Lew, Walther, Pang y Shin hicieron el experimento que todo el mundo debería conocer y que casi nadie conoce6.
Variaron dos cosas de forma independiente. Una era qué tan rápido llegaba una respuesta, ocho segundos contra cuarenta. La otra era si la respuesta era contingente, es decir, hecha a la medida de lo que la persona había preguntado, frente a una respuesta genérica y enlatada. 131 adultos estadounidenses vieron un chat simulado de servicio al cliente y lo calificaron en cuatro resultados.
La velocidad no produjo un efecto principal significativo en ninguno de los cuatro. La contingencia produjo efectos significativos en los cuatro, con tamaños del efecto de 0.48 a 0.66.
Los autores habían predicho que las respuestas lentas y genéricas serían las peores. Se equivocaron, y lo dicen ellos mismos. Las respuestas rápidas y genéricas obtuvieron la calificación más baja en todos los resultados. Su explicación es que una respuesta rápida que no se involucra parece robótica, y que sin una demora que sugiera que la persona está ocupada, en el mejor de los casos se lee como desatenta.
El titular práctico que yo sacaría de toda esta literatura es que apurarte a mandar algo vacío es peor que tomarte tu tiempo y mandar algo real.
Una respuesta rápida y vacía no se ve mal en la pantalla. Se ve eficiente. El problema solo se vuelve visible cuando te preguntas qué le provoca a la persona que la está leyendo.
La única táctica que se generaliza
Haz una pregunta de seguimiento sobre lo que la otra persona acaba de decir.
Huang, Yeomans, Brooks, Minson y Gino hicieron tres estudios de conversaciones en vivo7. En un estudio de chat en línea con 199 díadas, a las personas a quienes se instruyó hacer muchas preguntas les caían significativamente mejor a sus interlocutores, y la capacidad de respuesta percibida mediaba el efecto. Un segundo estudio lo replicó y rastreó el efecto hasta las preguntas de seguimiento en particular, es decir, preguntas que solo podían surgir de haber leído la respuesta anterior. Un componente de citas rápidas encontró que la tasa de preguntas de seguimiento predecía las ofertas de una segunda cita.
Tres notas sobre este artículo, porque es discutido y eso importa. Hay una disputa publicada. Kluger y Malloy reanalizaron el estudio de citas rápidas y argumentaron que el efecto desaparece en cuanto tomas en cuenta quién estaba haciendo las preguntas, y los autores originales respondieron que el reanálisis usó la medida equivocada y un modelo inadecuado8. Yo diría que los experimentos de conversación son el respaldo más sólido, y el componente de citas rápidas la parte discutida. El artículo tiene una corrección publicada desde marzo de 2025, y no tiene ninguna expresión de preocupación ni retractación. Y un estudio con terceros dentro del mismo artículo encontró que observadores que leían las transcripciones no compartían esa preferencia, lo cual es una condición de frontera real.
Por separado, la gente evita hacer preguntas delicadas porque teme ofender, y sobreestima de forma significativa ese costo9. Ya sea la pregunta de seguimiento obvia o la delicada, la pregunta que no estás haciendo probablemente sea segura de hacer.
Nombra la cosa específica
Packard y Berger aislaron la concreción lingüística como una señal de que alguien está escuchando10. Cinco estudios, incluyendo análisis de texto de más de 1,000 interacciones reales con clientes en dos entornos de campo. Los clientes quedaban más satisfechos, estaban más dispuestos a comprar y gastaban más cuando la persona que respondía usaba un lenguaje concreto, y el mecanismo era que inferían que el empleado estaba prestando atención. Un aumento de una desviación estándar en la concreción mejoró la satisfacción en un 9 por ciento y el gasto en al menos un 13.
Creo que la traducción es inusualmente limpia. “Esa playera gris”, no “tu problema”. “La junta del jueves”, no “lo que mencionaste”. Nombrar el objeto específico es lo que se lee como haber escuchado, y no cuesta nada. También es lo más fácil de verificar de forma mecánica.
Si es una conversación difícil, llama por teléfono
Este es el resultado más citable de todo el conjunto, y te va a molestar.
Bevis, Schroeder y Yeomans hicieron experimentos aleatorizados con 1,576 personas en conversaciones, distribuidas en 1,842 conversaciones, más 1,432 observadores11. Las conversaciones habladas produjeron mayor comprensión percibida y menor conflicto percibido que las escritas, además de que le caías mejor a la otra persona, más disfrute y mayor cambio de actitud. Combinando sus primeros tres estudios, hablar elevó la comprensión en un beta estandarizado de 0.45 y redujo el conflicto en 0.23.
Luego les preguntaron a las personas qué elegirían. El 83.9 por ciento prefería escribir cuando esperaba un desacuerdo, y predijo que escribir produciría menos conflicto y más comprensión. Sus experimentos encontraron lo contrario.
Hay un giro que le da sentido a este artículo. El lenguaje receptivo, es decir, matizar tus afirmaciones, reconocer el punto de vista contrario antes de contraargumentar, y nombrar puntos reales de acuerdo, predijo resultados constructivos con más fuerza en la escritura que en el habla12. Para los autores es un acertijo que la gente use menos lenguaje receptivo justo en el medio donde parece importar más.
Así que si tienes que escribirlo, los movimientos de receptividad importan más de lo que importarían en una llamada. Si tienes la opción, la llamada sale mejor de lo que esperas.
Salvedades que los propios autores señalan: la mayoría de los participantes eran desconocidos entre sí, el conflicto fue bajo en todas las condiciones, y la mayoría eran estudiantes. Dos personas que se conocen bien, discutiendo sobre algo central para su relación, podrían comportarse distinto.
Respuestas de espera, y por qué el consejo obvio necesita una condición
No encontré ningún experimento que compare directamente un “lo vi, te contesto bien en un rato” corto contra una respuesta completa y demorada sin nada de por medio. El mecanismo sí está bien respaldado, así que trataría esto como razonamiento y no como un hallazgo.
La incertidumbre sobre si vas a contestar o no es justo lo que la investigación sobre latencia identifica como la parte dañina1. Una respuesta de espera atiende exactamente eso. Giurge y Bohns mostraron que una nota breve para establecer expectativas redujo una mala lectura ya documentada2.
Pero Lew y colegas le ponen una condición6. Una respuesta de espera genérica es una respuesta rápida y no contingente, que es justo la combinación que salió peor calificada de las cuatro en su estudio. Las dos te compran los mismos días de margen. Solo una nombra algo.
Genérica “Gracias por tu correo, nos pondremos en contacto”
Rápida y no contingente, exactamente la combinación que salió peor calificada en cada resultado del estudio de Lew y colegas6
Específica “Ya leí lo del cronograma y necesito hasta el jueves para contestarte bien”
Dónde entra la IA en todo esto
Vale la pena ser preciso aquí, porque la evidencia es más interesante de lo que dicen tanto quienes la promueven como quienes la critican.
Rubin y colegas hicieron nueve estudios con 6,282 participantes13. Todas las respuestas fueron generadas por IA. Lo que variaba era la etiqueta. Los investigadores presentaron algunas como escritas por un humano y otras como escritas por IA. Los participantes calificaron las respuestas etiquetadas como humanas como más empáticas y solidarias, y esas respuestas produjeron más emoción positiva. Incluso la sospecha espontánea de los propios participantes, sin que nadie se la sugiriera, de que la IA había ayudado a escribir una respuesta etiquetada como humana también reducía la empatía percibida. El resultado se replicó con distintas extensiones, demoras y modelos, y lo impulsaron las respuestas que enfatizaban compartir emociones más que la comprensión práctica.
Lee el diseño con cuidado, porque de ahí depende qué significa el hallazgo. Esta es evidencia sobre atribución y creencia. No es evidencia de que la IA escriba peores mensajes, porque la IA escribió todos y cada uno. Reviso más de estos estudios en si los reescritores de mensajes con IA de verdad funcionan.
Un patrón parecido aparece en otro lado. En dos experimentos aleatorizados con 1,020 participantes, las respuestas inteligentes (smart replies) aumentaron la eficiencia y el lenguaje positivo, y los participantes que creían que su interlocutor las estaba usando calificaron a esa persona como menos cooperativa, incluso después de controlar por el uso real14. La penalización la cargaba la creencia, no el uso. Y un estudio anterior sobre perfiles escritos con IA encontró que la confianza era similar cuando todo estaba escrito por IA o todo estaba escrito por humanos, y solo caía cuando la gente tenía que adivinar15.
Hay aquí un contrahallazgo, y no lo voy a pasar por alto. Ovsyannikova, Oldemburgo de Mello e Inzlicht encontraron que evaluadores externos percibían a la IA como más compasiva que a humanos expertos, y que eso se sostenía incluso cuando los evaluadores sabían que era IA16. Los dos resultados no son fáciles de conciliar entre sí. Puede que la diferencia esté entre evaluar el intercambio de alguien más y recibir tú mismo el mensaje.
Yo pondría justo al lado otro estudio sobre la penalización de las respuestas inteligentes que mencioné arriba, porque ese estudio encontró lo contrario. Mieczkowski y colegas pusieron a participantes a intercambiar mensajes en los que una de las partes usaba respuestas inteligentes sugeridas, y quienes los recibían no calificaron peor en calidez ni en competencia a los remitentes que las usaban17. Junto a la penalización de la fuente 14, que dependía solo de la creencia, los dos estudios apuntan desde lados distintos a la misma conclusión, que la ayuda real de la IA no se castiga de forma evidente, mientras que la sospecha de que la otra persona está delegando el esfuerzo sí se castiga.
Liu, Mittal, Yang y Bruckman pusieron a prueba esa sospecha directamente, con tres tipos de correo, una consulta sobre un producto, una invitación a una fiesta y un mensaje para consolar a un amigo cuya mascota había muerto, cada uno presentado como escrito por IA18. La confianza bajó a medida que subía la participación que se le atribuía a la IA, y bajó más en el correo emocional, que es lo que los autores esperaban desde el principio. Lo que no esperaban fue que la confianza subiera, y no bajara, cuando había más en juego en la relación, así que el mensaje de consuelo etiquetado como IA terminó generando más confianza que la consulta sobre un producto etiquetada como IA. Su propia hipótesis predecía el orden contrario. En entrevistas posteriores, los diez participantes dijeron sin rodeos que no querrían que una IA escribiera nada emocional por ellos, lo cual no coincidía con lo que sus propias calificaciones acababan de mostrar. Lo que la gente dice que toleraría y lo que mueve su confianza no son lo mismo aquí.
Khadpe y colegas encontraron el mecanismo que está debajo de ambos resultados. Etiquetar un mensaje como asistido por IA le baja puntos, y además atenúa lo que ese mensaje le dice a quien lo lee sobre el carácter de quien lo envía, en las dos direcciones. Un mensaje cálido se lee menos cálido una vez etiquetado, y uno frío se lee menos frío19. Así que la etiqueta te cuesta algo de crédito por tu calidez, pero sobre todo hace que el mensaje deje de contar como evidencia de quién eres.
Como alguien que dirige un producto en esta categoría, entiendo que lo útil es ayudarte a escribir algo que sea tuyo, y que lo dañino es una respuesta que se lee como subcontratada. Eso llega al mismo lugar que todo lo demás en este artículo. La respuesta funciona cuando demuestra que te involucraste, y nada que se salte el paso de involucrarte sobrevive al contacto con la persona que lo lee.
Subtext trabaja a partir de lo que tú ya escribiste en lugar de reemplazarlo, y te muestra cuánto cambió. Esa decisión de diseño es la única que la evidencia respalda, no una postura de marketing.
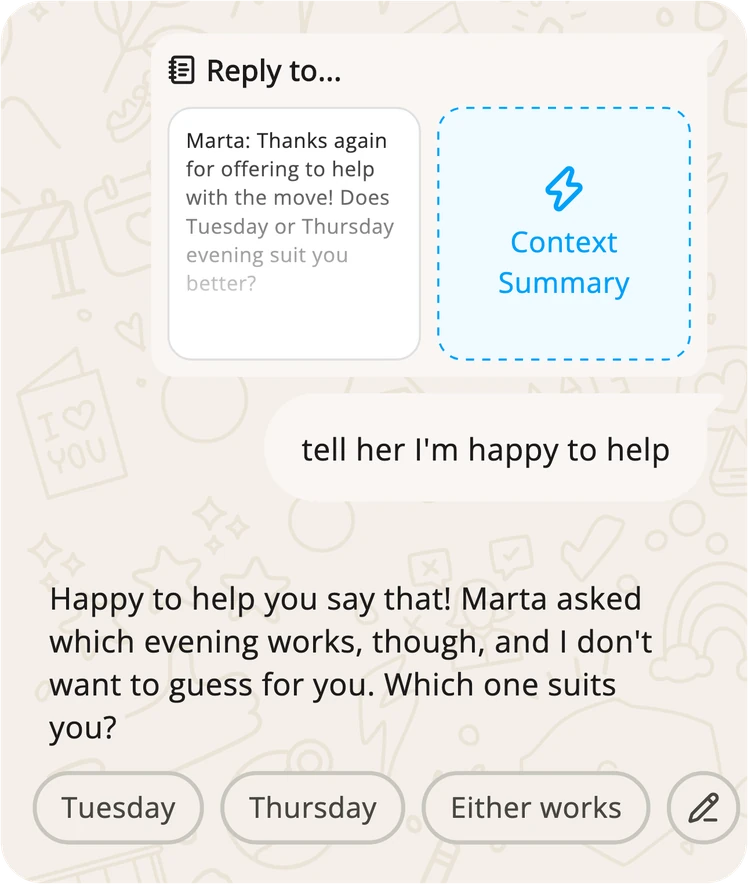
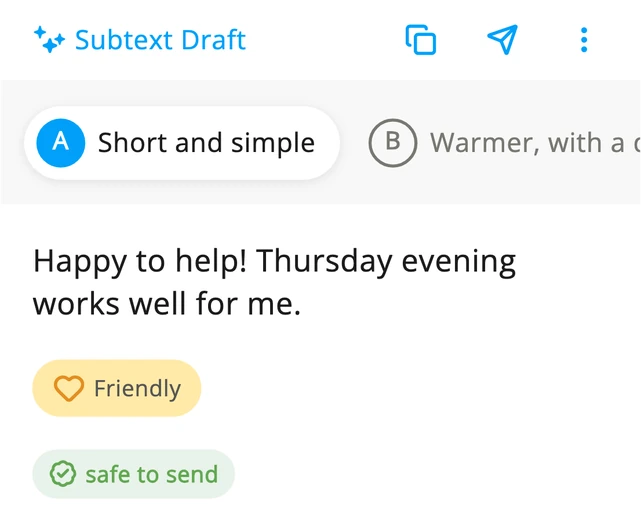
Subtext también está hecho para no adivinar por ti. Con un mensaje de Marta, inventado para la prueba, “Thanks again for offering to help with the move! Does Tuesday or Thursday evening suit you better?” (en español: “¡Gracias otra vez por ofrecerte a ayudar con la mudanza! ¿Te queda mejor el martes o el jueves en la noche?”), y la petición “tell her I’m happy to help” (dile que con gusto la ayudo), no escribió ninguna versión. Dijo “Happy to help you say that! Marta asked which evening works, though, and I don’t want to guess for you. Which one suits you?” (en español: “¡Con gusto te ayudo a decirle eso! Pero Marta preguntó qué día te queda en la noche, y no quiero adivinar por ti. ¿Cuál te acomoda?”) y ofreció tres respuestas para tocar, Tuesday, Thursday y Either works (martes, jueves y cualquiera de los dos). Una respuesta armada solo con la petición se habría saltado su pregunta. Con la respuesta Thursday, la primera versión que escribió decía “Happy to help! Thursday evening works well for me.” (en español: “¡Con gusto ayudo! El jueves en la noche me queda bien.”). Esa es la respuesta real, tal como la devolvió la app.
Subtext te puede ayudar a matizar, reconocer y nombrar acuerdos, y te va a decir si una respuesta de espera es del tipo genérico o del específico, porque las dos se ven parecidas y no califican nada parecido. Solo trabaja sobre lo que escribes, así que el argumento para que mejor levantes el teléfono te toca hacerlo a ti.
Prueba Subtext en tu navegadorDescárgalo en el App StoreDescárgalo en Google PlayEscanéalo con la cámara de tu celular para instalar.
Cómo se ve esto según el contexto
El problema de fondo es el mismo en todos lados. Cómo lo resuelves cambia lo suficiente como para engañarte si generalizas.
- Trabajo y contexto comercial. Con desconocidos en una transacción, la velocidad pesa de verdad. Con colegas, el error documentado es sobreestimar la urgencia. Los detalles concretos y un siguiente paso claro ayudan en todos los casos.
- Citas. Aquí el momento en que mandas el mensaje señala algo, de una forma en que no pasa en otros contextos, y responde a un punto óptimo curvilíneo, no a una regla fija. Un mensaje moderadamente demorado después de una primera cita funcionó mejor que uno inmediato y que uno muy demorado, y el mismo estudio no encontró respaldo para un mecanismo de hacerse del rogar20.
- Apoyo. Aquí la capacidad de respuesta lo es todo, y un apoyo que no responde a lo que la persona necesita puede ser peor que ninguno. Maisel y Gable encontraron, en un estudio con 67 parejas que vivían juntas, que el apoyo ayudaba solo cuando coincidía con lo que la persona necesitaba21. Cuando la noticia es mala, trato por separado qué decir cuando no sabes qué decir.
- Conflicto. Matiza, reconoce, nombra los acuerdos reales y, si puedes, levanta el teléfono. Una vez que ya pasó la pelea, qué textear después de una pelea es una pregunta distinta.
Por eso Subtext lee el mensaje que tiene enfrente y no aplica una sola regla en todos lados. Cómo se ve “estar involucrado” en un hilo de trabajo y en un mensaje de primera cita no es lo mismo, aunque el problema de fondo sí lo sea.
Reglas sin nada detrás
La regla de los cinco minutos para responder un lead. La afirmación de que contestar dentro de cinco minutos eleva la conversión 21 veces se remonta a documentos técnicos de proveedores. La investigación de fondo sobre velocidad de respuesta y contratos es real1. El multiplicador no lo es.
La demora de tres horas para textear en citas. No encontré respaldo empírico, y el estudio más cercano al tema explícitamente no encontró el mecanismo de escasez que necesitaría para sostenerse20.
Los parámetros de referencia de correo profesional y las cifras de expectativas de servicio al cliente. Circulan mucho, y su fuente son comunicados de prensa de negocios y reportes de proveedores sin muestras reveladas.
“El 31 por ciento de las personas ve el texteo como una fuente diaria de ansiedad.” La fuente es un blog comercial, y no pude rastrear ningún estudio detrás de la cifra.
Fuentes
Numeradas en el orden en que aparecen arriba. Cuando una cifra no se pudo verificar contra la fuente primaria, el texto lo dice. Verificado el 28 de agosto de 2026.
- Hart, E., VanEpps, E. M., Sezer, O., y Amir, O. (2026). Speed Is a Signal: When Faster Replies Increase Hiring Likelihood. Management Science, publicado en línea el 3 de junio de 2026.
- Giurge, L. M., y Bohns, V. K. (2021). “You don’t need to answer right away!” Organizational Behavior and Human Decision Processes, 167, 114 a 128.
- Barber, L. K., y Santuzzi, A. M. (2015). Please respond ASAP: Workplace telepressure and employee recovery. Journal of Occupational Health Psychology, 20(2), 172 a 189.
- Huang, Q., y Yao, S. (2024). No response? Chronemic expectancy violation and relational turbulence in technologically-mediated romantic relational conflict. Journal of Social and Personal Relationships, 41(5), 1183 a 1206. 200 estudiantes de 18 a 23 años de una universidad pública en Austin, 162 analizados. No preregistrado, sin financiamiento.
- Kalman, Y. M., y Rafaeli, S. (2011). Online Pauses and Silence: Chronemic Expectancy Violations in Written Computer-Mediated Communication. Communication Research, 38(1), 54 a 69.
- Lew, Z., Walther, J. B., Pang, A., y Shin, W. (2018). Interactivity in Online Chat: Conversational Contingency and Response Latency in Computer-Mediated Communication. Journal of Computer-Mediated Communication, 23(4), 201 a 221. 131 adultos estadounidenses, edad media 51.32.
- Huang, K., Yeomans, M., Brooks, A. W., Minson, J., y Gino, F. (2017). It Doesn’t Hurt to Ask: Question-Asking Increases Liking. Journal of Personality and Social Psychology, 113(3), 430 a 452. Tiene una corrección publicada desde marzo de 2025, y no tiene ninguna expresión de preocupación ni retractación. Datos en osf.io/8k7rf.
- Kluger, A. N., y Malloy, T. E. (2019). Journal of Personality and Social Psychology, 117(6), 1132 a 1138, con la respuesta de los autores en Yeomans, Brooks, Huang, Minson y Gino (2019), 117(6), 1139 a 1144.
- Hart, E., VanEpps, E. M., y Schweitzer, M. E. (2021). The (better than expected) consequences of asking sensitive questions. Organizational Behavior and Human Decision Processes, 162, 136 a 154.
- Packard, G., y Berger, J. (2021). How Concrete Language Shapes Customer Satisfaction. Journal of Consumer Research, 47(5), 787 a 806.
- Bevis, B., Schroeder, J., y Yeomans, M. (2026). Spoken disagreement is more constructive than written disagreement. Nature Communications, 17, artículo 5792. Acceso abierto; preregistros y datos en OSF.
- Yeomans, M., Minson, J., Collins, H., Chen, F., y Gino, F. (2020). Conversational receptiveness: Improving engagement with opposing views. Organizational Behavior and Human Decision Processes, 160, 131 a 148.
- Rubin, M., Li, J., Zimmerman, F., Ong, D. C., Goldenberg, A., y Perry, A. (2025). Comparing the value of perceived human versus AI-generated empathy. Nature Human Behaviour, 9(11), 2345 a 2359. Nueve estudios, 6,282 participantes; todas las respuestas fueron generadas por IA y solo varió la etiqueta.
- Hohenstein, J., Kizilcec, R. F., DiFranzo, D., y colegas (2023). Artificial intelligence in communication impacts language and social relationships. Scientific Reports. Dos experimentos aleatorizados, 1,020 participantes.
- Jakesch, M., French, M., Ma, X., Hancock, J. T., y Naaman, M. (2019). AI-Mediated Communication: How the Perception that Profile Text was Written by AI Affects Trustworthiness. CHI 2019. 527 participantes.
- Ovsyannikova, D., Oldemburgo de Mello, V., y Inzlicht, M. (2025). Third-party evaluators perceive AI as more compassionate than expert humans. Communications Psychology, 3(1), 4. Va en contra de la dirección de la fuente 13; aquí se nombran las dos sin intentar reconciliarlas.
- Mieczkowski, H., Hancock, J. T., Naaman, M., y Jung, M. F. (2021). AI-Mediated Communication: Language Use and Interpersonal Effects in a Referential Communication Task. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), artículo 17.
- Liu, Y., Mittal, A., Yang, D., y Bruckman, A. (2022). Will AI Console Me when I Lose my Pet? Understanding Perceptions of AI-Mediated Email Writing. CHI 2022. Tres escenarios de correo con cada vez más en juego en la relación: una consulta sobre un producto, una invitación a una fiesta y consolar a un amigo por la muerte de su mascota; diez entrevistas de seguimiento.
- Khadpe, P., Wenzel, D., Loewenstein, G., y Kaufman, G. (2025). Explaining the Reputational Risks of AI-Mediated Communication: Messages Labeled as AI-Assisted Are Viewed as Less Diagnostic of the Sender’s Moral Character. Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society, 8, 1413 a 1423.
- Teichmann, F., Petrowsky, H. M., Boecker, L., Soliman, M., y Loschelder, D. D. (2026). Journal of Social and Personal Relationships. Efecto curvilíneo del momento del mensaje después de una primera cita; no se encontró respaldo para un mecanismo de escasez.
- Maisel, N. C., y Gable, S. L. (2009). The Paradox of Received Social Support: The Importance of Responsiveness. Psychological Science, 20(8), 928 a 932. 67 parejas que vivían juntas.